
Modification of mechanical properties of polylactic acid based on random forest algorithm
-
摘要:
聚乳酸作为一种可生物降解材料,在包装、医疗器械等领域具有广阔的应用前景,但力学性能的不足仍是制约其大规模推广应用的主要瓶颈。为提升聚乳酸的力学性能,并实现改性过程的智能化控制,本文提出一种基于随机森林算法的性能预测与工艺优化方法,构建了数据驱动型的聚乳酸改性智能配置系统。研究中选取涵盖改性剂种类、添加量、相对分子质量、玻璃化转变温度等工艺参数的19项输入特征与拉伸强度和断裂伸长率2个输出目标,建立并训练随机森林回归模型。结果表明,优化后的模型在拉伸强度和断裂伸长率2个性能指标上均表现出较高的预测精度,残差分布集中、拟合趋势良好,具备较强的非线性建模能力和特征冗余容忍度,在解释数据方差与控制预测误差方面表现稳定,可满足实际工程应用需求。进一步的特征重要性分析显示,改性剂添加量、玻璃化转变温度与相对分子质量是影响聚乳酸力学性能的关键因素,在多变量组合下对性能响应具有显著作用。本研究在建模过程中建立了可持续更新的聚乳酸改性数据集结构,后续可通过补充新样本或特征实现数据库扩展与模型再训练,从而在数据层面具备良好的可扩展性与样本适应性,为生物基材料的性能预测与工艺参数优化提供了标准化、可复制、可推广的数据驱动解决方案。
Abstract:Polylactic acid, as a biodegradable material, has broad application prospects in packaging, medical devices and other fields. However, the insufficiency of its mechanical properties remains the main bottleneck restricting its large-scale promotion and application. To enhance the mechanical properties of polylactic acid and achieve intelligent control of the modification process, this paper proposes a performance prediction and process optimization method based on the random forest algorithm and constructs a data-driven intelligent configuration system for polylactic acid modification. In the study, 19 input features covering process parameters such as modifier types, addition amounts, relative molecular mass, and glass transition temperatures, along with two output targets, tensile strength and elongation at break, were selected to establish and train a random forest regression model. The results show that the optimized model demonstrates high prediction accuracy in both tensile strength and elongation at break performance indicators. The residual distribution is concentrated, the fitting trend is good, and it has strong nonlinear modeling ability and feature redundancy tolerance. It is stable in interpreting data variance and controlling prediction errors, and can meet the requirements of practical engineering applications. Further analysis of the importance of features revealed that the addition amount of modifiers, glass transition temperature and relative molecular mass are the key factors affecting the mechanical properties of polylactic acid, and they have a significant effect on the performance response under the combination of multiple variables. In the modeling process of this study, a sustainably updated dataset structure of polylactic acid modification was established. Subsequently, database expansion and model retraining can be achieved by supplementing new samples or features, thus demonstrating good scalability and sample adaptability at the data level. It provides a standardized, replicable and scalable data-driven solution for the performance prediction and process parameter optimization of bio-based materials.
-
0. 引言
随着公众环保意识的增强和对塑料污染问题的关注,新型的可生物降解材料——聚乳酸(polylactic acid,PLA)因优异的生物相容性、可加工性和环境友好性,在包装、生物医学和环保材料等领域广受欢迎 [1]。PLA是以植物淀粉为原料合成的一种可生物降解的脂肪族聚酯,不仅在生产过程中不会产生污染,使用后还可被彻底分解为CO2和H2O而被大自然吸收和利用 [2]。然而,因固有的脆性、低韧性、拉伸强度(tensile strength,TS)不可控等缺陷限制了其在工程材料和高性能领域的应用。
为提升PLA的力学性能,近年来研究者广泛采用共聚 [3]、共混 [4]、纳米填料增强 [5]与增塑剂引入 [6]等手段改性,已显著改善了其TS与断裂伸长率(elongation at break,EAB)等功能。其中,如将改性木质素接枝乳酸用于PLA共混可显著提高其韧性和水稳定性;与聚对苯二甲酸-己二酸丁二醇酯(poly(butylene adipate-co-terephthalate),PBAT)等柔性聚酯共混可有效提升其EAB;引入石墨烯等纳米填料有助于同时增强其力学与热稳定性;此外,采用热塑性聚氨酯弹性体(thermoplastic polyurethane,TPU)类增塑剂制备的PLA共混体系亦在冲击强度与相容性方面表现出良好效果。现有大多数PLA改性研究仍采用试错式实验设计,需反复调整实验条件以获得目标性能,导致研发周期长、成本高,且难以系统识别各工艺参数与性能响应之间的非线性关系。
针对上述问题,已有一些学者将学习工具数据驱动的建模手段引入到高分子材料领域。姜会钰等 [7]把人工神经网络方法用在活性染料染色上,预测活性染料染色后的Kubelka-Munk function(K/S)值,该结果和实验值的相关系数达到了0.995;马凯 [8]采用XGBoost算法进行数据建模,设计出一个涤纶短纤维纺丝性能预测神经网络模型,输入聚酯纤维的性能要求可智能自动配置出相对应的过程工艺参数。除此之外,机器学习还在工程控制与系统优化、高分子材料加工与性能预测、制造业自动化与智能决策、农业气象风险评估、新能源设备健康监测等领域有了应用 [9-13]。为提升PLA改性过程的智能化水平,本文拟构建一个基于随机森林(random forest,RF)算法的性能预测模型,利用收集整理的大量PLA复合材料改性实验数据,以实现对TS与EAB的精准预测,并进一步挖掘关键影响因子,从而为PLA材料的高效设计与性能调控提供理论支持与技术路径。
1. 数据来源
为构建PLA力学性能预测模型所需的数据集,本文基于science direct、web of science、中国知网及google scholar等在线数据库,收集整理了1980—2025年公开发表的120篇关于PLA基复合材料改性实验的研究文献,经筛选与整合后,形成包含300多个有效实验数据点。本研究在建模过程中建立了可持续更新的PLA改性数据集结构,后续可通过补充新样本或特征实现数据库扩展与模型再训练,从而在数据层面具备良好的可扩展性与样本适应性。为保证数据来源的代表性与多样性,本文所采用的样本涵盖不同改性剂类型、混合工艺及测试标准。各类别样本总体分布较为分散,部分稀有类别样本量相对较少,整体上未出现严重的不均衡问题。为减小不同实验室、测试标准及设备差异带来的系统偏差,本文在数据预处理阶段将测试标准、混合工艺等实验条件作为分类变量纳入模型训练,通过独热编码方式显式引入这些差异信息,使模型能够自动学习不同来源数据的影响规律。同时,对数值型特征变量采用标准化处理,以消除不同量纲对模型训练的影响,进一步降低数据异质性造成的误差。模型输出变量包括TS和EAB共2个力学性能指标。输入变量共计19项,其中数值型变量12项、分类变量7项。数值变量包括PLA相对分子质量(relative molecular mass,MW)、玻璃化转变温度(glass transition temperature,TG)、改性剂添加量(modifier addition,MA)、拉伸速度(tensile speed,SS)、样条横截面积(area,AREA)、样条长度(length,LL)、宽度(width,LW)、厚度(thickness,LT)、混合温度(mixing temperature,MT)和测试温度(performance temperature,PT)等;分类变量包括改性剂种类(modifier,MOD)、测量标准(standard,STD)、混合工艺(mixing process,MP)和测试工艺(performance process,PP)等。
所涉及的改性剂类型涵盖脂肪族聚酯类、生物基共聚物类等,主要包括聚己内酯、聚(对苯二甲酸-己二酸-丁二醇酯)、聚羟基丁酸酯、聚丁二酸丁二醇酯、柠檬酸酯类、偏脂肪酸酯、柠檬烯、月桂烯、聚乙二醇、聚丙二醇、纤维素纳米晶和聚碳酸丙烯酯等。
2. 研究方法
2.1 RF算法
RF是一种基于集成学习思想的监督学习算法 [14],集成学习示意如图 1所示,通过集成多棵决策树进行预测,可有效提升模型的泛化能力并降低过拟合风险。选择RF算法作为本研究的核心模型,主要基于以下考虑:RF通过引入自助采样与特征随机选择机制,能在多决策树集成下有效降低单模型过拟合风险,适用于样本数量有限且特征维度较高的PLA改性数据集;与传统线性回归或支持向量回归相比,RF能够自动捕捉工艺参数与力学性能之间的复杂非线性关系,无需显式设定函数形式;PLA文献数据来源多样、存在异质性,RF在样本扰动下仍保持稳定预测性能,具有较强的泛化能力,综合考虑上述因素,RF模型能够较好地满足本研究的需求。
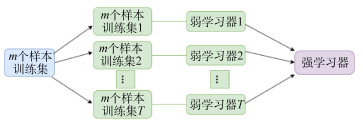 图 1 集成学习示意注:m为样本数量;T为训练集编号。Fig. 1 schematic diagram of ensemble learning
 下载:
全尺寸图片
作为Bagging方法的扩展形式,RF的基本流程如图 2所示。RF在每棵树的训练过程中引入特征子集的随机选择机制,增强了基学习器的多样性,从而提高整体模型的稳定性与准确性。与单棵决策树不同,RF在模型构建过程中包含“双重随机”机制。首先,对原始样本进行随机有放回抽样以生成若干子数据集;其次,在每个节点分裂时仅从全部特征中随机抽取部分特征进行最优划分,从而有效提升模型的泛化能力与鲁棒性。
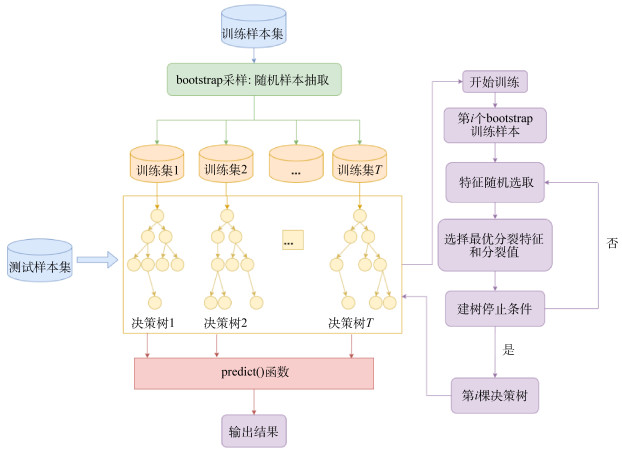 图 2 随机森林算法流程Fig. 2 random forest algorithm flow下载:
全尺寸图片
在样本抽取过程中,采用自助采样法 [15],方法示意如图 3所示。即从包含m个样本的数据集D中有放回抽样,形成子数据集D '。估算公式为
$$ \lim\limits _ {m \rightarrow \infty} \left(1-\frac {1}{m}\right) ^ {m} = \frac {1}{\mathrm{e}} \approx 0.3 6 8, $$ 约有63.2%的样本被用于训练,其余作为验证集。通过对每个采样集训练一个基学习器,最终对所有决策树预测结果,取算术平均得到最终输出为
$$ \hat {y} = \frac {1}{N _ {\text {estimators }}} \sum\limits_ {i = 1} ^ {N _ {\text {estimators }}} \hat {y} _ {i}, $$ 式中:Nestimators为代码中设置的决策树数量$ ; \hat { y } _ { i } $是第i棵树的预测值。
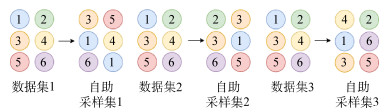 图 3 自主采样法Fig. 3 schematic diagram of bootstrap sampling下载:
全尺寸图片
2.2 超参数优化与交叉验证
(1)超参数搜索。为提升PLA预测模型的泛化能力,本研究采用网格搜索 [16]与5折交叉验证 [17]相结合的超参数优化策略,系统探索RF算法的关键参数组合,参数空间的设定基于预实验与领域先验知识。为防止模型在高维特征空间中过拟合并提升特征选择的科学性,本文在RF模型中对关键超参数进行了量化控制,与模型训练结果相关的主要关键参数有:①决策树数量,控制森林中决策树的总数;②单树最大深度,限制单棵决策树的生长深度;③特征随机抽样数,单棵树进行节点分裂时随机选择的特征数,有效平衡模型复杂性与高维特征空间的过拟合风险;④节点分裂所需的最小样本数,用于限制节点继续分裂所需的最小样本量;⑤叶节点所需的最小样本数,约束叶节点中的最小样本数量。
(2)交叉验证法。该方法能够在保持样本分布稳定的同时,提供更全面的模型泛化能力评估结果。在机器学习模型评估中,测试集被广泛用于估计学习器的泛化误差,5折交叉验证示意如图 4所示。原始数据集被等分为5个子集,记为D1、D2、D3、D4和D5。每次迭代中,选择其中1个子集作为测试集,其余4个子集作为训练集,共进行5轮训练与验证,最终将5次结果汇总,以评估模型性能的稳定性与泛化能力,该方法通过数据划分与轮换机制,在保证训练、测试互斥性的同时充分利用有限样本。
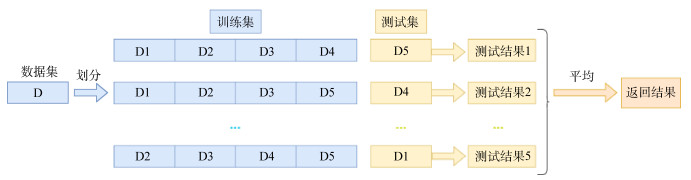 图 4 5折交叉验证示意注:D1~D5为子集。Fig. 4 illustration of 5-fold cross-validation下载:
全尺寸图片
2.3 特征相关性分析方法
为揭示输入变量之间的相关性,采用皮尔逊相关系数r对所有输入特征统计线性相关性,r为[-1, 1],越接近1表示正相关性越强。|r|≥0.8为极强相关,0.6≤ |r| < 0.8为强相关,0.4≤ |r| < 0.6为中等相关,0.2≤ |r| < 0.4为弱相关,|r| < 0.2为极弱相关。相关性结果以热力图方式呈现,辅助变量筛选与冗余识别,为后续建模提供支持 [18]。
2.4 预测性能评估指标
RF算法的预测准确性通过决定系数(R2)、平均绝对误差(mean absolute error,MAE)、残差分布图和预测散点图判断。
R2是衡量预测值与真实值的拟合程度,采用计算差值的平方避免误差出现正负抵消的情况,R2越接近1说明模型解释数据变异的能力越强 [19],计算公式为
$$ R ^ {2} = 1-\frac {\sum\limits_ {i} \left(\widehat {y _ {i}}-y _ {i}\right) ^ {2}}{\sum\limits_ {i} \left(\overline {{y _ {i}}}-y _ {i}\right) ^ {2}}, $$ 式中: $ \widehat{y_i} $ 为预测值$ ; { \overline { { y _ { i } } } } $为平均值;yi为真实值。
MAE反映预测值与真实值的平均绝对偏差,是用于衡量回归模型精度的重要指标,能够直观反映预测结果的平均误差水平,其值越小表示模型拟合效果越好 [20],计算公式为
$$ E _ {\mathrm{MA}} = \frac {1}{n} \sum\limits_ {i = 1} ^ {n} | \widehat {y _ {i}}-y _ {i} |, $$ 式中:EMA为MAE值;n为决策树个数;yi为预测值; $ \widehat{y_i} $ 为真实值。
残差图是最常见的残差分析工具,通过绘制残差分布图来评估模型的拟合效果,以判断模型的性能、发现潜在问题,并改进 [21],计算公式为
$$ E = y _ {\text {true }}-y _ {\text {prediction }}, $$ 式中:E是残差;ytrue是实际值;yprediction是预测值。
预测散点图用于全面评价模型预测能力,以直观观察模型对PLA样本在不同性能区间的预测拟合程度,同时绘制残差分布图分析误差分布结构,辅助判断模型稳定性和偏差特征。
2.5 特征重要性与交互分析方法
为量化各输入变量对PLA材料性能的影响程度,基于RF模型输出的特征重要性分析评分 [22]。通过统计特征在决策树节点分裂中贡献的信息增益,计算其对模型预测结果的平均影响权重。为更直观呈现特征组合对力学性能的交互效应,以3个主要变量为轴,绘制三维特征重要性曲面图,展示目标值随特征组合变化的趋势,用于辅助识别显著非线性交互关系及关键参数区间。
3. 结果
3.1 交互式特征关联
PLA改性实验中各输入变量间的相关性如图 5所示。依据皮尔逊相关系数,LT与AREA、MT与PT、LL与LW依次为极强、强、中等相关(r=0.85、0.79、0.46),其余变量间相关性不高。
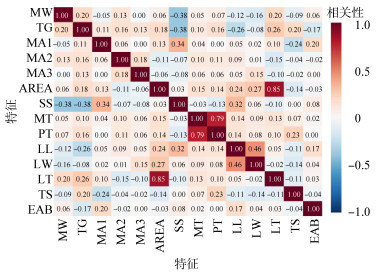 图 5 交互式特征关联注:MW为相对分子质量;TG为玻璃化转变温度;MA为改性剂添加量;AREA为样条横截面积;SS为拉伸速度;MT为混合温度;PT为测试温度;LL为样条长度;LW为宽度;LT为厚度;TS为拉伸强度;EAB为断裂伸长率。Fig. 5 interactive feature association下载:
全尺寸图片
3.2 超参数优化结果
在PLA力学性能预测模型的超参数优化阶段,采用Python平台下的Scikit-learn机器学习库,结合网格搜索与5折交叉验证方法,对RF模型的关键参数系统调优。RF调参与交叉验证的执行过程与搜索路径如图 6所示。在设定的参数空间中,共执行了1 000次模型训练与验证实验。最终获得最优参数组合,即决策树数量为350、单树最大深度为20、特征随机抽样数为6、节点分裂所需的最小样本数为2、叶节点所需的最小样本数为1。
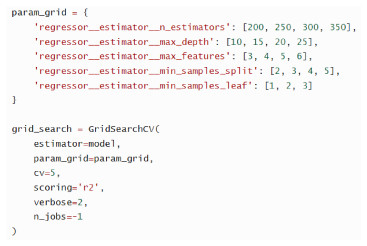 图 6 调参细节程序Fig. 6 parameter tuning details program下载:
全尺寸图片
3.3 模型性能评估结果
(1)真实值与预测值对比。在训练集与测试集上的模型预测结果与真实值对比如图 7所示。在TS方面,训练集和测试集的R2=0.956和0.735,MAE分别为2.865和7.032;EAB方面,训练集和测试集的R2=0.926和0.612,MAE分别为16.639和52.664。模型在训练集上拟合效果优异,在测试集亦具备一定预测精度。
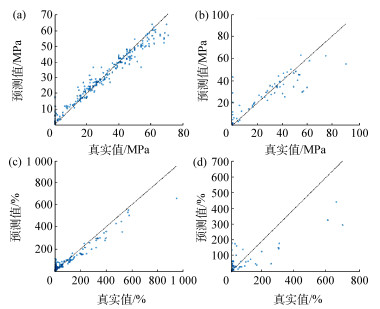 图 7 不同数据集真实值与预测值训练(a)TS训练集;(b)TS测试集;(c)EAB训练集;(d)EAB测试集Fig. 7 comparison of predicted and actual values across datasets(a) TS training set; (b) TS test set; (c) EAB training set; (d) EAB test set下载:
全尺寸图片
(2)残差分布特征。模型在TS与EAB的残差分布特征如图 8所示。TS残差近似正态分布,集中于0附近,分布相对对称;EAB残差分布较为分散,右偏明显,存在部分大幅度误差点,显示模型在部分高EAB值区间预测偏差较大。
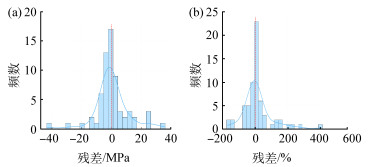 图 8 不同数据集残差分布(a)TS;(b)EABFig. 8 esidual distribution of different datasets(a) TS; (b) EAB下载:
全尺寸图片
(3)预测结果。真实值与预测值在样本排序维度下的变化趋势如图 9所示。TS预测曲线与真实值变化基本一致;而EAB预测曲线在高值区间略有波动偏差,但整体趋势仍保持较高一致性。
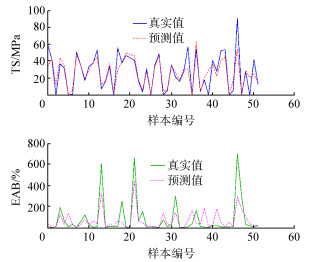 图 9 不同数据集预测结果比较(a)TS;(b)EABFig. 9 comparison of prediction results of different datasets(a) TS; (b) EAB下载:
全尺寸图片
(4)特征重要性分析。各输入特征对PLA的TS与EAB相对重要性评分如图 10所示。各因素对TS和EAB的影响程度有所不同,在TS预测中,MA为最主要影响因素,其次为TG与MW;在EAB预测中,MA同样排名第一,紧随其后的是测试样条尺寸类特征(LL、LW、LT)和TG。
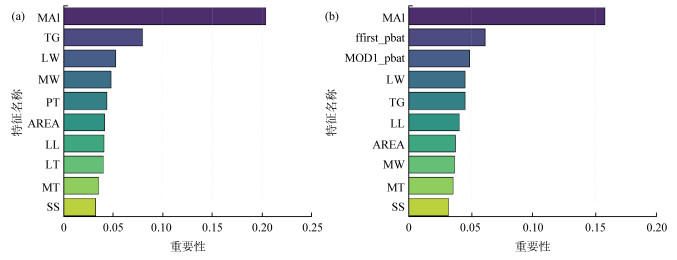 图 10 不同数据集前10项特征重要性分布注:first_pbat为改性剂 PBAT;MOD1_pbat为改性剂 PBAT 添加量。
(a)TS;(b)EABFig. 10 distribution of feature importance(a) TS; (b) EAB下载:
全尺寸图片
(5)交互效应。TS与EAB的三维特征重要性曲面图如图 11所示。不同MA、TG与样条尺寸组合下的模型预测响应,表明3个变量存在显著非线性交互关系,且在TG约为60 ℃附近出现多个性能峰值区域。
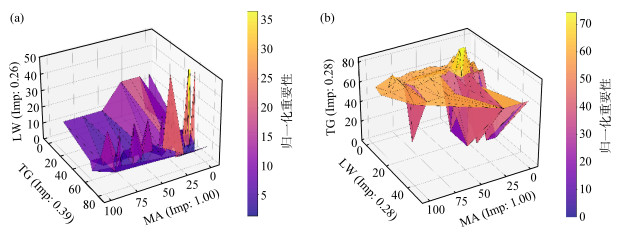 图 11 三维特征重要性曲面图注:Imp为归一化重要性。
(a)TS;(b)EABFig. 11 three-dimensional feature importance surface map(a) TS; (b) EAB(a)TS; (b)EAB下载:
全尺寸图片
4. 讨论
4.1 特征相关性分析讨论
交互式特征关联分析表明MT与PT呈现显著正相关,表明在PLA改性工艺中,二者具有较强的参数联动性,需在工艺设计阶段保持温控系统的一致性与协调性。LT与AREA、LL与LW等尺寸类变量之间的高度相关也提示部分特征存在相关性,后续建模中可通过特征选择方法降维,以减少多重共线性对模型性能的影响。
考虑到样条几何参数(如LL、LW、LT和AREA)之间存在一定的线性相关性,本文尝试对相关特征进行剔除与主成分降维测试。结果显示,降维后模型在TS与EAB预测中的R2均有所下降,表明这些特征虽存在相关性,但在非线性集成学习模型中仍共同参与了性能表征。RF通过特征随机抽样与多树集成的机制,在一定程度上可抑制共线性带来的过拟合风险,并保留有助于性能预测的特征交互信息。基于此,本研究最终保留了全部特征,以确保模型在预测精度与物理可解释性之间取得平衡。
4.2 调参策略与模型配置分析
调参结果显示适度增加森林中决策树数量与控制树深度有助于提升模型精度与稳定性。较大的决策树数量为350,对数据复杂性的拟合能力强;单树最大深度为20,有效避免过拟合;设置特征随机抽样数为6,实现了在高维特征空间中的平衡选择,提升了模型训练效率与泛化能力;节点分裂所需的最小样本数为2,用于限制节点继续分裂所需的最小样本量;叶节点所需的最小样本数为1,约束叶节点中的最小样本数量。参数组合表明,在PLA改性预测任务中,模型需要同时兼顾非线性表达力与结构简洁性。参数配置在训练集与验证集上均表现出良好的预测效果,后续所有模型评估与性能分析均基于该参数设置展开。
4.3 模型评估与结果讨论
RF模型在TS预测任务中展现出优异的拟合能力与稳定性,训练集与测试集均获得较高的决定系数和较低的MAE,残差分布集中且近似对称,说明模型能够有效捕捉关键特征与目标变量之间的非线性映射关系,具备良好的泛化能力。在EAB预测方面,尽管测试集的误差较TS略高,但模型仍保持较强的趋势识别能力,特别是在中低区间段拟合效果稳定。对高值区间的预测偏差,主要与原始数据的波动性和测量误差有关,同时也反映出EAB对材料微观结构和非线性因子的高度敏感性。本研究的数据集由跨度近45年、来源于不同实验室与文献的多组实验结果组成,各研究在原料纯度、测试标准、设备精度及样品制备工艺等方面存在显著差异。其中,不同拉伸测试标准及测试环境条件对EAB测量结果具有较大影响,导致相同工艺下的实验值在文献间波动明显。虽然模型在TS预测上表现较好,但在EAB预测方面仍存在一定误差。未来工作可进一步通过尝试多种机器学习及深度学习算法进一步改善,以综合不同模型的优点并增强预测稳定性,为后续研究提供可扩展的改进方向。总体而言,本研究构建的RF模型在处理PLA复合材料复杂工艺参数、多类别变量与非线性关系方面具有显著优势,模型输出稳定、精度可控,验证了机器学习算法在高分子材料性能预测中的实用性与有效性。
4.4 特征重要性分析
MA在TS与EAB预测中均为关键因素,这是因为改变PLA力学性能最根本的物质就是改性剂,本文目的也是为了使用不同的改性剂对PLA改性,以期达到符合要求的力学性能。通过数据分析可知较高的MA可能引入了更多的功能基团,从而改善材料的韧性和强度。Lai等 [23]通过熔融制备了PLA和聚苯酯的共混物,证实随着共混物中聚苯酯含量增加到20.0%,其EAB从7.2%显著增加到227.0%,相比PLA提高了30倍。PLA的MW和TG是影响改性的第二大关键因素。一般来说,MW越大,分子间的相互作用力越强,熔融温度越高;当MW较低时,PLA的TS随MW的增大而加大。通过分析
EAB的影响因素,得出聚PBAT和高MW的聚己内酯对PLA的EAB存在明显的影响。PBAT是一种由1,4-丁二醇、己二酸和对苯二甲酸经过缩合聚合反应合成的可生物降解聚酯 [24]。PBAT的EAB高达560.0%~710.0%,TS可达35~45 MPa[25],表现出比PLA更高的韧性。因此,在PLA中加入PBAT可以有效提高PLA的韧性。Wang等 [26]把多功能环氧扩链剂作为反应增熔剂,通过熔融共混制备不同比例的PLA/PBAT共混物,将共混物的EAB增长至579.9%;Yang等 [27]将高MW的聚己内酯引入到PLA改性,表明EAB随聚己内酯的含量提高而增加。以上结果表明如果想提高PLA改性后的EAB,可以考虑共混PBAT等物质。这源于:(1)改性剂可能引入了更多的功能基团,从而改变了材料的韧性和强度,随着添加量的不同,TS和EAB随添加量不同呈现不同结果;(2)MW的提高可通过改变分子链缠结密度和结晶度,显著影响材料的TS和EAB。此外MW和TG作为结构参数,也在预测中表现出较高重要性。MW影响链段缠结程度和熔融黏度,TG决定聚链段活性温区,二者在改性机制中呈现协同调控关系。相关研究指出,较高的MW可增强材料的TS,尤其在结晶度增加条件下,其对机械性能的提升效果更显著 [28]。三维特征交互曲面图进一步揭示了变量之间存在显著的非线性交互作用,特别是在TG约为60 ℃的窗口下,不同MW与MA组合导致模型预测值出现明显峰值区域。该结果说明在PLA改性设计中,应重视关键参数之间的耦合影响,尤其在热参数与配比策略之间寻求协调匹配,以实现性能最优化。
综上所述,RF算法在PLA复合材料力学性能预测任务中展现出良好的适应性与稳定性。本研究:(1)探索RF算法在PLA改性性能建模中的系统化应用,以期为生物基材料的智能化设计提供新的思路与参考;(2)构建高品质数据集并融合交叉验证与网格搜索策略,显著提升模型稳定性与泛化能力;(3)提出交互式特征可视化分析方法,量化关键工艺因子之间的非线性交互关系,增强了模型的可解释性与实用性。
5. 结束语
本研究构建了基于RF算法的数据驱动型PLA改性工艺优化模型,该模型以工艺参数作为输入变量,力学性能作为输出变量,实现了高性能PLA复合材料的可预测性制备。研究结果表明:RF模型对工艺参数与力学性能响应的非线性关系捕捉能力显著;所构建的RF模型在TS与EAB指标上均具备较强的预测能力,使其在工业试错成本降低方面展现突出价值;系统探讨了MA、TG和MW等关键参数对TS与EAB的影响规律。研究过程中,结合文献数据构建特征数据库,完成了特征相关性分析、参数调优、模型构建与结果评估,全面验证了RF算法在高分子材料性能预测中的适用性与有效性。此外,本研究提出了一种基于模块化设计的机器学习预测框架,具备良好的可扩展性和适应性。该框架在引入动态特征融合机制与弹性参数优化策略后,其预测精度可随实验数据的扩充持续提升,实现了新数据的无缝整合与特征空间的自主扩展,显著增强了模型对复杂样本分布的泛化能力,为生物基材料的智能研发提供了标准化解决方案。
© The editorial department of Journal of Capital Normal University (Natural Science Edition) 2025.This is an open access article under the CC BY-NC-ND 4.0 license (https://creativecommons.org/licenses/by-nc-nd/4.0/). -
图 1 集成学习示意
注:m为样本数量;T为训练集编号。
Fig. 1 schematic diagram of ensemble learning
下载:
全尺寸图片
图 2 随机森林算法流程
Fig. 2 random forest algorithm flow
下载:
全尺寸图片
图 3 自主采样法
Fig. 3 schematic diagram of bootstrap sampling
下载:
全尺寸图片
图 4 5折交叉验证示意
注:D1~D5为子集。
Fig. 4 illustration of 5-fold cross-validation
下载:
全尺寸图片
图 5 交互式特征关联
注:MW为相对分子质量;TG为玻璃化转变温度;MA为改性剂添加量;AREA为样条横截面积;SS为拉伸速度;MT为混合温度;PT为测试温度;LL为样条长度;LW为宽度;LT为厚度;TS为拉伸强度;EAB为断裂伸长率。
Fig. 5 interactive feature association
下载:
全尺寸图片
图 6 调参细节程序
Fig. 6 parameter tuning details program
下载:
全尺寸图片
图 7 不同数据集真实值与预测值训练
(a)TS训练集;(b)TS测试集;(c)EAB训练集;(d)EAB测试集
Fig. 7 comparison of predicted and actual values across datasets
(a) TS training set; (b) TS test set; (c) EAB training set; (d) EAB test set
下载:
全尺寸图片
图 8 不同数据集残差分布
(a)TS;(b)EAB
Fig. 8 esidual distribution of different datasets
(a) TS; (b) EAB
下载:
全尺寸图片
图 9 不同数据集预测结果比较
(a)TS;(b)EAB
Fig. 9 comparison of prediction results of different datasets
(a) TS; (b) EAB
下载:
全尺寸图片
图 10 不同数据集前10项特征重要性分布
注:first_pbat为改性剂 PBAT;MOD1_pbat为改性剂 PBAT 添加量。
(a)TS;(b)EABFig. 10 distribution of feature importance
(a) TS; (b) EAB
下载:
全尺寸图片
图 11 三维特征重要性曲面图
注:Imp为归一化重要性。
(a)TS;(b)EABFig. 11 three-dimensional feature importance surface map
(a) TS; (b) EAB(a)TS; (b)EAB
下载:
全尺寸图片
-
[1] Zhai S X, Liu Q Y, Zhao Y L, et al. A review: research progress in modification of poly (lactic acid) by lignin and cellulose[J]. Polymers, 2021, 13(5): 776. DOI: 10.3390/polym13050776. [2] 马喜峰. 聚乳酸及其改性研究新进展[J]. 化学工程师, 2020, 34(10): 51-53. DOI: 10.16247/j.cnki.23-1171/tq.20201051. Ma Xifeng. New progress in polylactic acid and its modification[J]. Chemical Engineer, 2020, 34(10): 51-53. doi: 10.16247/j.cnki.23-1171/tq.20201051 [3] Zhang N, Zhao M, Liu G F, et al. Alkylated lignin with graft copolymerization for enhancing toughness of PLA [J]. Journal of Materials Science, 2022, 57(19): 8687-8700. DOI: 10.1007/s10853-022-07101-2. [4] Jiang L, Wolcott M P, Zhang J W. Study of biodegradable polylactide/poly (butylene adipate-co-terephthalate) blends[J]. Biomacromolecules, 2006, 7 (1): 199-207. DOI: 10.1021/bm050581q. [5] Valapa R B, Pugazhenthi G, Katiyar V. Effect of graphene content on the properties of poly (lactic acid) nanocomposites[J]. RSC Advances, 2015, 5(36): 28410-28423. DOI: 10.1039/C4RA15669B. [6] Jaratrotkamjorn R, Khaokong C, Tanrattanakul V. Toughness enhancement of poly (lactic acid) by melt blending with natural rubber[J]. Journal of Applied Polymer Science, 2012, 124(6): 5027-5036. DOI: 10.1002/app.35617. [7] 姜会钰, 杨锋, 王振东, 等. BP神经网络对活性染料染色K/S值的预测[J]. 染整技术, 2007, 29(8): 4-6, 1. DOI: 10.3969/j.issn.1005-9350.2007.08.003. JiangHuiyu, Yang Feng, Wang Zhendong, et al. K/S value prediction of reactive dyeing by BP neural network [J]. Textile Dyeing and Finishing Journal, 2007, 29(8): 4-6, 1. doi: 10.3969/j.issn.1005-9350.2007.08.003 [8] 马凯. 聚酯纤维生产过程工艺参数的智能配置[D]. 上海: 东华大学, 2019. Ma Kai. Intelligent configuration of process parameters in polyester fiber production process[D]. Shanghai: Donghua University, 2019. [9] 赵亚梅, 杨建国, 李蓓智. 基于神经网络预测模型输入参数配置方法的实现[J]. 计算机测量与控制, 2005, 13(9): 929-931. DOI: 10.16526/j.cnki.11-4762/tp.2005.09.019. ZhaoYamei, Yang Jianguo, Li Beizhi. Realization of parameter disposes based on ANN model[J]. Computer Automated Measurement & Control, 2005, 13(9): 929-931. doi: 10.16526/j.cnki.11-4762/tp.2005.09.019 [10] 汪艺. 基于集成智能的差别化纺丝性能双向预测方法[D]. 上海: 东华大学, 2014. Wang Yi. Integrated intelligence based bi-directional prediction approach for the performances of differential fibers[D]. Shanghai: Donghua University, 2014. [11] 吕志军, 宋一铭, 杨光辉, 等. 基于性能预测的货架智能配置模型研究与实践[J]. 制造业自动化, 2016, 38(11): 140-143. DOI: 10.3969/j.issn.1009-0134.2016.11.031. Lü Zhijun, Song Yiming, Yang Guanghui, et al. Performance prediction based intelligent configuration model on racking system and its application [J]. Manufacturing Automation, 2016, 38(11): 140-143. doi: 10.3969/j.issn.1009-0134.2016.11.031 [12] Han Y, He Y J, Liang Z R, et al. Risk assessment and application of tea frost hazard in Hangzhou City based on the random forest algorithm[J]. Agriculture, 2023, 13 (2): 327. DOI: 10.3390/agriculture13020327. [13] 祁炜雯, 张俊, 吴洋, 等. 基于改进BP-Bagging算法的光伏电站故障诊断方法[J]. 浙江电力, 2024, 43(3): 65-74. DOI: 10.19585/j.zjdl.202403008. QiWeiwen, Zhang Jun, Wu Yang, et al. A fault diagnosis method for photovoltaic power plants based on an enhanced BP-Bagging algorithm[J]. Zhejiang Electric Power, 2024, 43(3): 65-74. doi: 10.19585/j.zjdl.202403008 [14] Biau G, Scornet E. A random forest guided tour [J]. Test, 2016, 25(2): 197-227. DOI: 10.1007/s11749-016-0481-7. [15] Efron B. Bootstrap methods: another look at the jackknife[M]//Kotz S, Johnson N L, Breakthroughs in statistics. New York, NY: Springer, 1992: 569-593. DOI: 10.1007/978-1-4612-4380-9_41. [16] Bergstra J, Bengio Y. Random search for hyper-parameter optimization[J]. Journal of Machine Learning Research, 2012, 13: 281-305. DOI: 10.5555/2188385.2188395. [17] Arlot S, Celisse A. A survey of cross-validation procedures for model selection[PP/OL]. arXiv (2009-07-27) [2025-08-29]. https://arxiv.org/abs/0907.4728. [18] Benesty J, Chen J D, Huang Y T, et al. Noise reduction in speech processing[M]. Berlin, Heidelberg: Springer, 2009: 1-4. [19] Nagelkerke N J D. A note on a general definition of the coefficient of determination[J]. Biometrika, 1991, 78 (3): 691-692. DOI: 10.1093/biomet/78.3.691. [20] Legates D R, McCabe G J Jr. Evaluating the use of"goodness-of-fit" measures in hydrologic and hydroclimatic model validation[J]. Water Resources Research, 1999, 35 (1): 233-241. DOI: 10.1029/1998WR900018. [21] Beckett J, Schucany W R, Broffitt J D. A special distributional result for bilinear forms[J]. Journal of the American Statistical Association, 1980, 75(370): 466-468. DOI: 10.1080/01621459.1980.10477496. [22] Breiman L. Random forests[J]. Machine Learning, 2001, 45(1): 5-32. DOI: 10.1023/a: 1010933404324. [23] Lai S M, Liu Y H, Huang C T, et al. Miscibility and toughness improvement of poly (lactic acid)/poly (3-hydroxybutyrate) blends using a melt-induced degradation approach[J]. Journal of Polymer Research, 2017, 24(7): 102. DOI: 10.1007/s10965-017-1253-0. [24] Yan X X, Huang S J, Huan J, et al. Chemical recycling of poly (butylene terephthalate) into value-added biodegradable poly (butylene adipate-co-terephthalate) [J]. Polymer Chemistry, 2024, 15(20): 2047-2054. DOI: 10.1039/D4PY00068D. [25] Mohammadi M, Heuzey M C, Carreau P J, et al. Morphological and rheological properties of PLA, PBAT, and PLA/PBAT blend nanocomposites containing CNCs[J]. Nanomaterials, 2021, 11(4): 857. DOI: 10.3390/nano11040857. [26] Wang X, Peng S X, Chen H, et al. Mechanical properties, rheological behaviors, and phase morphologies of high-toughness PLA/PBAT blends by in-situ reactive compatibilization[J]. Composites Part B: Engineering, 2019, 173: 107028. DOI: 10.1016/j.compositesb.2019.107028. [27] Yang Z T, Yang J X, Fan J H, et al. Preparation of super-toughened poly (L-lactide) composites under elongational flow: a strategy for balancing stiffness and ductility[J]. Composites Science and Technology, 2021, 208: 108758. DOI: 10.1016/j.compscitech.2021.108758. [28] Tsuji H, Ikada Y. Properties and morphologies of poly (llactide): 1. annealing condition effects on properties and morphologies of poly (l-lactide) [J]. Polymer, 1995, 36 (14): 2709-2716. DOI: 10.1016/0032-3861(95)93647-5.
