
Multi factor pension problem under a Markov regime switching model
-
摘要: 本文将马尔科夫机制转换模型创新性地引入到通货膨胀、随机利率等因素影响的确定缴费型(DC)养老金问题中。假定金融模型中各参数依赖于连续时间马尔科夫链描述的市场经济状态,通过利用养老金终端财富期望效用最大化准则,得到了在常数绝对风险厌恶效用函数(CARA)下最优投资策略显式解。最后通过数值分析表明,市场利率、通货膨胀率等因素对风险资产投资比例有不同程度负影响,且在不同经济状态下的最优投资策略具有显著差异。Abstract: This paper creatively introduces the Markov regime switching model into the defined contribution (DC) pension problem affected by inflation, random interest rate and other factors. It assumes that the parameters in the financial model depend on the market economy state described by the continuous time Markov chain, and obtains the explicit solution of the optimal investment strategy under the Constant Absolute Risk Aversion (CARA) utility function by using the rule of maximizing the expected utility of the wealth of the pension terminal. Finally, the numerical analysis shows that market interest rate, inflation rate and other factors have different degrees of negative impact on the proportion of venture capital investment, and the optimal investment strategy under different economic conditions has significant differences.
-
Keywords:
- DC pension /
- Markov regime switching /
- inflation /
- stochastic interest rate /
- optimal investment
-
0. 引言
随着我国经济的快速发展,医疗条件逐步提高,社会福利越来越好。在各种因素的共同作用下,我国人口的平均寿命在提升。根据2020年第七次人口普查数据,我国60岁及以上的人口数量为26 402万人,在全国人口的比例达到18.70%。在2011—2020年,60岁及以上人口比例上升了5.44%。为了保障退休后的个人生活,给个人财富增值和强制储蓄,人们对养老金的关注度越来越高。
目前实行基金积累制的养老保险计划可分为确定给付(defined benefit,DB)型和确定缴费(defined contribution,DC)型2种。DC养老金计划是指养老金计划成员通过建立养老保险账户的形式,由企业或者是企业职工定期向养老金账户支付一定比例的保险费,而员工退休时获得养老金的收益金额完全取决于个人账户的财富积累的结果(包括投资收益和自然增长的收益)。因此,有关DC养老金计划投资组合的选择和最优资产配置已成为业界关注的重点问题。1971年Merton[1]最先利用随机最优控制理论处理数理金融学中的最优投资消费问题,并建立了终端财富和综合效用最优的投资组合模型;Boulier等[2]首次研究了服从Vasicek模型的随机利率的DC养老金连续模型,在考虑担保的情况下,解决了效用函数为CRRA时养老金的最优投资问题;Gao[3]关注一个恒定的方差弹性(constant elasticity of variance model,CEV)模型,并用该模型描述股票价格,另外其还应用随机最优控制方法处理模型中的移动默顿策略和修正因子。
通货膨胀严重影响养老金未来的价值,并且对于金融市场的影响也是显著的。Battocchio和Menoncin[4]研究了一个连续时间内固定缴费的养老基金的随机模型,在这类模型中,基金经理需要面对薪酬和通胀2种背景风险;殷俊和李媛媛[5]在随机利率和通货膨胀的背景下,用通货膨胀指数化债券来对冲因通货膨胀因素导致的金融资产的风险;费为银等[6]结合展望理论的相关特点,研究了利用通货膨胀因素折现后的终端财富的预期效用最大化的问题;Baltas等[7]研究了在通货膨胀、死亡率和模型不确定性的影响下,确定缴费型养老金在分配阶段的最优管理问题。
基于养老金时间跨度的特性,在分析养老金投资问题时需要注意利率的随机性和波动性,并结合利率风险加以研究。张初兵和荣喜民[8]假设随机利率遵循仿射利率过程,运用Legendre转换,将养老金最优投资问题转化为对偶问题。Guan和Liang[9]在随机利率满足Ornstein-Uhlenbeck过程的背景下,研究养老金管理者在损失厌恶和风险价值(value at risk,VaR)约束下选择最优资产分配问题;吴津津等[10]针对3类随机因素,探究了模糊厌恶型的DC养老金的鲁棒最优投资策略。一个参数恒定的金融市场只能服务相对较短的时间,因此,为使养老金模型更加贴近金融市场,可在养老金最优投资问题中引入马尔科夫转换机制。Hamilton[11]最早于1989年提出马尔科夫机制转换模型,定义了变量在各状态之间的转换服从马尔科夫过程,由此大量学者研究人员开始关注这个模型;Yao等[12]考虑了马尔科夫调节风险模型下利用跳-扩散模型模拟盈余过程的保险公司的最优投资问题;甘少波等[13]将马尔科夫转换机制与养老金结合,考虑常数利率下风险资产、无风险资产和缴费的养老金最优投资问题;Korn等[14]在马尔科夫机制转换模型下DC养老金的最优投资问题中,提出了一种基于鲁棒滤波器的期望最大(expectation-maximization algorithm,EM)算法来估计未知参数。
本文在甘少波等[13]建立的马尔科夫机制转换的养老金模型基础上,将通货膨胀、随机利率等因素代入养老金投资收益模型中,并利用终端财富最大效用准则,得出显式解。结合市场的具体情况,分析不同影响因子对于养老金收益的影响。
1. 金融市场模型
定义一个具有滤流的完备概率空间(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P),其满足通常条件,P表示市场中真实的概率测度。在时间[0,T]内,假定文中的金融市场是一个连续无摩擦,可以任意进行交易,无套利的完备市场,且文中所有使用的随机变量和随机过程都定义在该完备概率空间(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P) 中。
模型中存在2个可交易的金融资产,即无风险资产(S0,即现金)和风险资产(S′,即股票)在时间[0,T]内可连续交易,且市场经济状态的变化会影响这2种资产的价格。用一个连续时间时齐马尔科夫链ε = {εs}0≤st≤t来描述其经济状态,ε的状态空间为Ξ = {e1,e2,…,eN},其中ei = {0,0,…,0,1,0,…,0}表示第i个元素为1,其他元素为0的N维列向量。马尔科夫链的强度矩阵假定为 Q = (qij)i,j=1,2,…,N且是保守的。
1.1 常利率下考虑通货膨胀模型
假定市场利率为常值r,且r > 0。无风险资产S0在t时刻的价格满足方程
$$ \mathrm{d} S_0=r S_0 \mathrm{~d} t, $$ (1) 此外,假定风险资产S' 在t时刻的价格满足
$$ \mathrm{d} S^{\prime}(t)=S^{\prime}(t)\left(\mu\left(\varepsilon_t\right) \mathrm{d} t+\sigma\left(\varepsilon_t\right) \mathrm{d} W_{1 t}\right), $$ (2) 式中W1是定义在概率空间(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P) 上的标准布朗运动。μ (εt),σ (εt) 分别是风险资产S' 的预期回报率和波动率,均依赖市场状态。
参考王传玉等[15]对于通货膨胀因素的处理,考虑通货膨胀折扣率为定义在(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P) 上的可测适应过程,且满足下面的随机微分方程
$$ \mathrm{d} P(t)=P(t)\left(\mu_p\left(\varepsilon_t\right) \mathrm{d} t+\sigma_p\left(\varepsilon_t\right) \mathrm{d} W_{1 t}\right), P(0)=1, $$ (3) 式中:μp (εt) 为预期即期通货膨胀率;σp (εt) 为通货膨胀波动率。
利用通货膨胀率式(3)对风险资产价格式(2)进行折算,计算出经过通胀因素折现后的真实风险资产价格为$S(t)=\frac{S^{\prime}(t)}{P(t)}$,应用Itô公式,得到S (t) 满足微分方程
$$ \begin{aligned} & \mathrm{d}\left(S_t\right)=S(t)\left[\left(\mu\left(\varepsilon_t\right)-\mu_p\left(\varepsilon_t\right)+\sigma_p^2\left(\varepsilon_t\right)-\right.\right. \\ & \left.\left.\quad \sigma_p\left(\varepsilon_t\right) \sigma\left(\varepsilon_t\right)\right) \mathrm{d} t+\left(\sigma\left(\varepsilon_t\right)-\sigma_p\left(\varepsilon_t\right)\right) \mathrm{d} W_{1 t}\right]。 \end{aligned} $$ (4) 考虑员工的工资缴费,员工的工资与金融市场相关,因此假定企业员工的工资Y满足
$$ \mathrm{d} Y(t)=Y(t)\left(\mu_y\left(\varepsilon_t\right) \mathrm{d} t+\delta\left(\varepsilon_t\right) \mathrm{d} W_{2 t}\right), $$ (5) 式中W2也是定义在概率空间(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P)上的标准布朗运动。μy (εt),δ (εt) 分别是随机工资Y的预期增长率和波动率,同样依赖市场状态。
为了便于计算,当市场状态εt = ei时,记
$$ \begin{aligned} & \mu\left(\varepsilon_t\right)=\mu(i), \sigma\left(\varepsilon_t\right)=\sigma(i), \mu_p\left(\varepsilon_t\right)=\mu_p(i), \\ & \sigma_p\left(\varepsilon_t\right)=\sigma_p(i), \mu_y\left(\varepsilon_t\right)=\mu_y(i), \delta\left(\varepsilon_t\right)=\delta(i)。 \end{aligned} $$ 1.2 随机利率下考虑通货膨胀模型
无风险资产(即现金)S0在t时刻的价格满足方程
$$ \mathrm{d} S_0=r(t) S_0 \mathrm{~d} t, \quad S_0(0)=S_0, $$ (6) 这里的r (t) 是随机利率,其满足Vasicek模型,服从Ornstein-Unlenbeck(OU)过程:
$$ \mathrm{d} r(t)=a(b-r(t)) \mathrm{d} t-\sigma_r \mathrm{~d} W_{r t}, \quad r(0)=r_0, $$ (7) 式中:a、b、σr均为正的常数,Wr是定义在概率空间(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P) 上的标准布朗运动。
此外,假定风险资产S'(即股票)在t时刻的价格满足
$$ \begin{array}{l} \mathrm{d} S^{\prime}(t)=S^{\prime}(t)\left(r(t) \mathrm{d} t+\sigma_1\left(\varepsilon_t\right)\left(\lambda_r\left(\varepsilon_t\right) \mathrm{d} t+\mathrm{d} W_{r t}\right)+\right. \\ \quad \quad \quad \left.\sigma_2\left(\varepsilon_t\right)\left(\lambda_s\left(\varepsilon_t\right) \mathrm{d} t+\mathrm{d} W_{s t}\right)\right), S^{\prime}(0)=S_0^{\prime}, \end{array} $$ (8) 式中:Ws是完备概率空间(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P) 上的一个标准布朗运动,其和Wr独立;λr是Wr的风险价格;λs是Ws的市场风险价格,代表该资产在承担股票风险后的收益;σ1,σ2均为正。由此可见,股票价格是由相互独立的双布朗运动驱动的。
考虑通货膨胀折扣率为定义在(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P) 上的可测适应过程,满足随机微分方程
$$ \begin{aligned} \mathrm{d} P(t) & =P(t)\left(\mu_p\left(\varepsilon_t\right) \mathrm{d} t+\sigma_{p 1}\left(\varepsilon_t\right) \mathrm{d} W_{r t}+\sigma_{p 2}\left(\varepsilon_t\right) \mathrm{d} W_{s t}\right), \\ P(0) & =1, \end{aligned} $$ (9) 式中:μp (εt)为预期即期通货膨胀率;σp1 (εt)和σp2 (εt) 均为通货膨胀波动率,均在[0,T] × Ω上可测,且是一致有界过程。
利用通货膨胀率式(9)对风险资产价格式(8)进行折算,得到折现后带有随机利率的真实风险资产价格为$S(t)=\frac{S^{\prime}(t)}{P(t)}$,应用Itô公式,得到S (t) 满足如下微分方程:
$$ \begin{aligned} \mathrm{d}\left(S_t\right)= & S(t)\left[\left(r(t)+\mu_k\left(\varepsilon_t\right)\right) \mathrm{d} t+\left(\sigma_1\left(\varepsilon_t\right)-\right.\right. \\ & \left.\left.\sigma_{p 1}\left(\varepsilon_t\right)\right) \mathrm{d} W_{r t}+\left(\sigma_2\left(\varepsilon_t\right)-\sigma_{p 2}\left(\varepsilon_t\right)\right) \mathrm{d} W_{s t}\right], \end{aligned} $$ (10) $$ \begin{aligned} \mu_k\left(\varepsilon_t\right)= & \sigma_1\left(\varepsilon_t\right) \lambda_r\left(\varepsilon_t\right)+\sigma_2\left(\varepsilon_t\right) \lambda_s\left(\varepsilon_t\right)-\mu_p\left(\varepsilon_t\right)+ \\ & \sigma_{p 1}^2\left(\varepsilon_t\right)+\sigma_{p 2}^2\left(\varepsilon_t\right)-\sigma_{p 1}\left(\varepsilon_t\right) \sigma_1\left(\varepsilon_t\right)- \\ & \sigma_{p 2}\left(\varepsilon_t\right) \sigma_2\left(\varepsilon_t\right) 。 \end{aligned} $$ 另外,假定企业员工的工资在引入随机利率后满足
$$ \mathrm{d} Y(t)=Y(t)\left(\mu_y\left(\varepsilon_t\right) \mathrm{d} t+\delta\left(\varepsilon_t\right) \mathrm{d} W_{y t}\right), \quad Y(0)=Y_0, $$ (11) 式中:μy (εt),δ (εt) 分别是随机工资Y的预期增长率和波动率;Wy是完备概率空间(Ω,$\mathcal{F}$,{$\mathcal{F}$t}t∈[0,T],P)上的一个标准布朗运动,与Ws、Wr独立。
为了方便计算,当εt = ei时,记
$$ \begin{aligned} & \mu_k\left(\varepsilon_t\right)=\mu_k(i), \sigma_1\left(\varepsilon_t\right)=\sigma_1(i), \sigma_2\left(\varepsilon_t\right)=\sigma_2(i), \\ & \mu_p\left(\varepsilon_t\right)=\mu_p(i), \sigma_{p 1}\left(\varepsilon_t\right)=\sigma_{p 1}(i), \\ & \sigma_{p 2}\left(\varepsilon_t\right)=\sigma_{p 2}(i), \mu_y\left(\varepsilon_t\right)=\mu_y(i), \delta\left(\varepsilon_t\right)=\delta(i) 。 \end{aligned} $$ 2. 最优化问题
在现实生活中,养老金计划参与者应当在每个月的特定时刻向账户中缴费,为了便于计算,本文采用连续时间公式表示工资Y(t),并且假定DC养老金参与成员连续向其养老金账户里按工资的固定比例0 < c < 1缴费。设在t时刻养老金管理者投资于风险资产(股票)所占总养老金的财富份额的为π (t),则投资于无风险资产(现金)S0所占的总财富的份额为1 - π (t)。因此,财富过程Xπ (t) 在养老金投资期限[0,T]内满足随机微分方程
$$ \begin{gathered} \mathrm{d} X^\pi(t)=\frac{\pi(t) X^\pi(t)}{S(t)} \mathrm{d} S(t)+ \\ \frac{(1-\pi(t)) X^\pi(t)}{S_0(t)} \mathrm{d} S_0(t)+c Y(t) \mathrm{d} t。 \end{gathered} $$ (12) 2.1 常利率下考虑通货膨胀的最优投资
考虑常数市场利率下的养老金最优投资问题,根据式(1)和(4)可得养老金财富过程为
$$ \begin{aligned} \mathrm{d} X^\pi(t)= & X^\pi(t)\left[r+\pi(t)\left(\mu\left(\varepsilon_t\right)-\mu_p\left(\varepsilon_t\right)+\sigma_p^2\left(\varepsilon_t\right)-\right.\right. \\ & \left.\left.\sigma_p\left(\varepsilon_t\right) \sigma\left(\varepsilon_t\right)-r\right)\right] d t+X^\pi(t)\left(\sigma\left(\varepsilon_t\right)-\right. \\ & \left.\sigma_p\left(\varepsilon_t\right)\right) \pi(t) \mathrm{d} W_{1 t}+c Y(t) \mathrm{d} t。 \end{aligned} $$ (13) 定义2.1 如果{π (t)}t=0T是$\mathcal{F}$循序可测的(初值为常数π0),且$E\left[\int_0^T \pi^2(s) \mathrm{d} s\right]<\infty$,则称养老金管理者的投资策略{π (t)}t=0T是可允许的。
令Λ (T) 表示所有可允许投资策略{π (t)}t=0T的集合,并考虑养老金管理者的效用函数为U(x),由于无论是养老金参与者或是养老金财富管理者都是风险厌恶的,所以效用函数是凹函数且严格递增的(U′ (x) > 0,U″(x) < 0)。结合养老金成员退休时刻所得财富的期望效用最大化原则,管理者的目的是在满足式(13)的情况下寻求下式的最优策略,即
$$ \max\limits_{\pi \in \mathit{\Lambda }(T)} E\left[U\left(X^\pi(T)\right) \mid X^\pi(t)=x, Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right], $$ 式中E [·|Xπ (t) = x,Y (t) = y,εt = ei] 表示在取定Xπ (t) = x,Y (t) = y,εt = ei下的条件期望。
设在时间[t,T] 内V (t,x,y,i) = $\max\limits_{\pi \in \mathit{\Lambda }(T)} E$[U (Xπ (T))|Xπ (t) = x,Y (t) = y,εt = ei],利用动态最优控制原理,值函数V (t,x,y,i) 满足Hamilton-Jacobi-Bellman(HJB)方程
$$ \begin{gathered} V_t(t, x, y, i)+\sup _{\pi \in \mathit{\Lambda }(T)}\left\{V_x(t, x, y, i) x[r+\pi(\mu(i)-\right. \\ \left.\left.\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r\right)\right]+V_x(t, x, y, i) c y+ \\ \left.\frac{1}{2} V_{x x}(t, x, y, i) \pi^2 x^2\left(\sigma(i)-\sigma_p(i)\right)^2\right\}+V_y(t, x, y, i) b(i) y+ \\ \frac{1}{2} V_{y y}(t, x, y, i) \delta^2(i) y^2+\sum\limits_{j=1}^N q_{i j}[V(t, x, y, j)- \\ V(t, x, y, i)]=0, \end{gathered} $$ (14) 式中:Vt (t,x,y,i),Vx (t,x,y,i),Vy (t,x,y,i),Vxx (t,x,y,i),Vyy (t,x,y,i) 分别表示V (t,x,y,i) 关于时间t,养老金财富x和员工工资y的一阶导数和x,y二阶导数,且具有边界条件V (T,x,y,i) = U (x)。
对于HJB方程的验证定理,将在下一节给出,这一节假设HJB方程的解存在,且Vx (t,x,y,i) > 0,Vxx (t,x,y,i) < 0。对最优投资策略π求导,并令方程等于0,可得
$$ \begin{gathered} V_x(t, x, y, i) x\left(\mu(i)-\mu_p(i)+\sigma_p^2(i)-\right. \\ \left.\sigma_p(i) \sigma(i)-r\right)+V_{x x}(t, x, y, i) \pi x^2(\sigma(i)- \\ \left.\sigma_p(i)\right)^2=0, \end{gathered} $$ 整理可得
$$ \begin{gathered} \pi^*(t, i)= \\ -\frac{\left(\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r\right) V_x(t, x, y, i)}{\left(\sigma(i)-\sigma_p(i)\right)^2 x V_{x x}(t, x, y, i)}, \end{gathered} $$ (15) 利用π* (t,i) 替换π (t) 是为了考虑不同经济状态下的最优投资组合策略。将π* (t,i) 代入式(14)中,得到值函数满足的偏微分方程为
$$ \begin{gathered} V_t(t, x, y, i)+V_x(t, x, y, i) x r- \\ \frac{1}{2} \frac{\left(\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r\right)^2 V_x^2(t, x, y, i)}{\left(\sigma(i)-\sigma_p(i)\right)^2 V_{x x}(t, x, y, i)}+ \\ V_x(t, x, y, i) c y+V_y(t, x, y, i) b(i) y+ \\ \frac{1}{2} V_{y y}(t, x, y, i) \delta^2(i) y^2+ \\ \sum\limits_{j=1}^N q_{i j}[V(t, x, y, j)-V(t, x, y, i)]=0。 \end{gathered} $$ (16) 其边界条件为V (T,x,y,i) = U (x)。
根据上述计算,得到了常数利率下考虑通货膨胀的养老金计划在效用函数为U(x)时,其最优投资策略为式(15),最优值函数满足式(16),终端边界条件为V (T,x,y,i) = U (x)。
2.2 随机利率下考虑通货膨胀的最优投资
考虑随机利率下带有通货膨胀的养老金最优投资问题,根据式(6)和(10)可知,养老金财富过程为
$$ \begin{gathered} \mathrm{d} X^\pi(t)=X^\pi(t)\left[r(t)+\pi(t) \mu_k\left(\varepsilon_t\right)\right] \mathrm{d} t+ \\ X^\pi(t) \pi(t)\left[\left(\sigma_1\left(\varepsilon_t\right)-\sigma_{p 1}\left(\varepsilon_t\right)\right) \mathrm{d} W_{r t}+\right. \\ \left.\quad\left(\sigma_2\left(\varepsilon_t\right)-\sigma_{p 2}\left(\varepsilon_t\right)\right) \mathrm{d} W_{s t}\right]+c Y(t) \mathrm{d} t, \end{gathered} $$ (17) $$ \begin{gathered} \mu_k\left(\varepsilon_t\right)=\sigma_1\left(\varepsilon_t\right) \lambda_r\left(\varepsilon_t\right)+\sigma_2\left(\varepsilon_t\right) \lambda_s\left(\varepsilon_t\right)-\mu_p\left(\varepsilon_t\right)+\sigma_{p 1}^2\left(\varepsilon_t\right)+ \\ \sigma_{p 2}^2\left(\varepsilon_t\right)-\sigma_{p 1}\left(\varepsilon_t\right) \sigma_1\left(\varepsilon_t\right)-\sigma_{p 2}\left(\varepsilon_t\right) \sigma_2\left(\varepsilon_t\right) 。 \end{gathered} $$ 养老金管理者的投资策略满足定义2.1,同样的,用Λ (T) 表示所有可允许养老金投资策略{π (t)}t=0T的集合,养老金管理者的效用函数为U(x)。在满足财富过程式(17)的情况下,养老金管理者的目标是探究基于养老金终端财富的期望效用最大化问题,即
$$ \begin{gathered} \max\limits_{\pi \in \mathit{\Lambda }(T)} E\left[U\left(X^\pi(T)\right) \mid X^\pi(t)=x, \right. \\ \left.Y(t)=y, r(t)=r, \varepsilon_t=\boldsymbol{e}_i\right] 。 \end{gathered} $$ (18) 令V (t,x,y,r,i)=$\max\limits_{\pi \in \mathit{\Lambda }(T)} E$ [U (Xπ (T))|Xπ (t)= x,Y(t) = y,r (t) = r,εt = ei],根据动态最优控制原理,得到值函数V (t,x,y,r,i) 满足如下HJB方程
$$ \begin{gathered} V_t(t, x, y, r, i)+V_r(t, x, y, r, i) a(b-r)+ \\ \frac{1}{2} V_{r r}(t, x, y, r, i) \sigma_r^2+ \\ \sup _{\pi \in \mathit{\Lambda }(T)}\left\{V_x(t, x, y, r, i) x\left(r(t)+\pi \mu_k(i)\right)+\right. \\ V_x(t, x, y, r, i) c y+ \\ \frac{1}{2} V_{x x}(t, x, y, r, i) \pi^2 x^2\left[\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\right. \\ \left.\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2\right]- \\ \left.V_{x r}(t, x, y, r, i) x \pi \sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right)\right\}+ \\ V_y(t, x, y, r, i) \mu_y(i) y+ \\ \frac{1}{2} V_{y y}(t, x, y, r, i) \delta^2(i) y^2+ \\ \sum\limits_{j=1}^N q_{i j}[V(t, x, y, r, j)-V(t, x, y, r, i)]=0, \end{gathered} $$ (19) 式中:Vt(t,x,y,r,i)、Vr(t,x,y,r,i)、Vx(t,x,y,r,i)、Vy(t,x,y,r,i)、Vrr(t,x,y,r,i)、Vxx(t,x,y,r,i)、Vyy(t,x,y,r,i)和Vxr(t,x,y,r,i)分别表示V (t,x,y,i) 关于时间t、随机利率r、财富x和工资y的一阶导数以及x,y二阶导数x,r的混合导数,且最终条件为V (T,x,y,r,i) = U (x)。
下面仿照Nicole Bäuerle等[16]的定理1,给出本文中考虑随机利率、通货膨胀等因素后的验证定理,同时给出相应的证明。
定理2.1 假设M (t,x,y,r,i) ∈ C1,2是上述式(19)HJB方程的一个解,对任意的i ∈ [1,2,…,N],t ∈ [0,T] 及t ∈ [0,T],满足增长条件:即存在常数K > 0及整数k、l、m,使得|M (t,x,y,r,i)|≤ K (1 +|x|k +|y|l +|r|m),则下面结果成立。
ⅰ)对任意的i ∈ [1,2,…,N],t ∈ [0,T] 及x ∈ R+,y ∈ R+,r ∈ R+,M (t,x,y,r,i) ≥ V (t,x,y,r,i);
ⅱ)对任意的i ∈ [1,2,…,N],t ∈ [0,T] 及x ∈ R+,y ∈ R+,r ∈ R+,如果π*使得HJB方程等号左侧的式子达到最大,则有M (t,x,y,r,i) = V (t,x,y,r,i) = Vπ* (t,x,y,r,i)。
这里Vπ* (t,x,y,i) = E[U (Xπ* (T))|Xπ* (t) = x,Y(t) = y,εt = ei],特别地π*是一个最优的投资策略。
证明 设π ∈ Λ (T) 为任意的投资组合策略,Xπ为相应的财富过程,将Itô引理应用于半鞅,得到
$$ \begin{gathered} M\left(T, X_T^\pi, Y_T, r_T, \varepsilon_T\right)=M(t, x, y, r, i)+ \\ \int_t^T\left[M_t\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right)+M_r\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) a\left(b-r_s\right)+\right. \\ \frac{1}{2} M_{r r}\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) \sigma_r^2+ \\ M_x\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) X_s^\pi\left(r(s)+\pi_s \mu_k\left(\varepsilon_s\right)\right) \\ +M_x\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) c Y_s- \\ M_{x r}\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) X_s^\pi \pi_s \sigma_r\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right)+ \\ \frac{1}{2} M_{x x}\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) \pi_s^2 X_s^{\pi 2}\left[\left(\sigma_1\left(\varepsilon_s\right)-\right.\right. \\ \left.\left.\sigma_{p 1}\left(\varepsilon_s\right)\right)^2+\left(\sigma_2\left(\varepsilon_s\right)-\sigma_{p 2}\left(\varepsilon_s\right)\right)^2\right]+ \\ M_y\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) \mu_y\left(\varepsilon_s\right) Y_s+ \\ \left.\frac{1}{2} M_{y y}\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) \delta^2\left(\varepsilon_s\right) Y_s^2\right] \mathrm{d} s+ \\ \int_t^T M_x\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) \pi_s X_s^\pi\left[\left(\sigma_1\left(\varepsilon_s\right)-\right.\right. \\ \left.\left.\sigma_{p 1}\left(\varepsilon_s\right)\right) \mathrm{d} W_r+\left(\sigma_2\left(\varepsilon_s\right)-\sigma_{p 2}\left(\varepsilon_s\right)\right) \mathrm{d} W_s\right]+ \\ \int_t^T M_y\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) Y_s \delta\left(\varepsilon_s\right) \mathrm{d} W_y+ \\ \int_t^T M_r\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) r_s \sigma_r \mathrm{~d} W_r+ \\ \sum\limits_{t \leqslant s <T}\left[M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_{s+}\right)-M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right)\right] 。 \end{gathered} $$ 用q0表示ε的跳跃测度,用Tn表示连续的跳跃时间点,设
$$ q_0([0, t] \times\{j\})=\sum\limits_{n \in \mathbf{N}} I_{\left[\varepsilon_{T_n+}=j, T_n \leqslant t\right]}, $$ q0的补偿器设为
$$ v([0, t] \times\{j\})=\int_0^t \sum\limits_{i \neq j} q_{i j} I_{\left[Y_s=i\right]} \mathrm{d} s \text { 。 } $$ 因此得到
$$ \begin{gathered} \sum\limits_{t \leqslant s <T}\left[M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_{s+}\right)-M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right)\right]= \\ \int_t^T \sum\limits_{j \in E}\left[M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_j\right)-\right. \\ \left.M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right)\right]\left(q_0-v\right)(\mathrm{d} s, j)+ \\ \int_t^T \sum\limits_{j \in E}\left[M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_j\right)-\right. \\ \left.M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right)\right] q_{\varepsilon_s j} \mathrm{~d} s。 \end{gathered} $$ 由于M满足HJB方程,
$$ \begin{gathered} M\left(T, X_T^\pi, Y_T, r_T, \varepsilon_T\right) \leqslant M(t, x, y, r, i)+ \\ \int_t^T M_x\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) \pi_s X_s^\pi\left[\left(\sigma_1\left(\varepsilon_s\right)-\right.\right. \\ \left.\left.\sigma_{p 1}\left(\varepsilon_s\right)\right) \mathrm{d} W_r+\left(\sigma_2\left(\varepsilon_s\right)-\sigma_{p 2}\left(\varepsilon_s\right)\right) \mathrm{d} W_s\right]+ \\ \int_t^T M_y\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) Y_s \delta\left(\varepsilon_s\right) \mathrm{d} W_y+ \\ \int_t^T M_r\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right) r_s \sigma_r \mathrm{~d} W_r+ \\ \int_t^T \sum\limits_{j \in E}\left[M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_j\right)-\right. \\ \left.M\left(s, X_s^\pi, Y_s, r_s, \varepsilon_s\right)\right]\left(q_0-v\right)(\mathrm{d} s, j) 。 \end{gathered} $$ 对两边求期望,根据边界条件得到M (T,XTπ,YTπ,rT,εT) = U (XTπ),由随机积分的性质,前3个积分的期望值为0;根据M的增长条件,可知$E\left[\sum\limits_{0 <T_i \leqslant T}\left|M\left(T_i, X_{T_i}^\pi, Y_{T_i}, r_{T_i}, \varepsilon_{T_i}\right)\right| \mid X^\pi(t)=x, Y(t)=\right.$y,r (t) = r,εt = ei] < ∞;第4个积分是鞅,在期望下为0,故E [U (XTπ)|Xπ (t) = x,Y (t) = y,r (t) = r,εt = ei] ≤ M (t,x,y,i)。
显而易见的是,当π*是HJB方程的极大值时,根据HJB方程的特点,可以得出M (t,x,y,r,i) ≤ E [U (XTπ)|Xπ (t) = x,Y (t) = y,r (t) = r,εt = ei],结合2个不等式,得到等式M (t,x,y,r,i) =V (t,x,y,r,i) = Vπ* (t,x,y,r,i)。结果得证。
假设HJB方程式(19)的解存在,且满足Vx (t,x,y,r,i) > 0,Vxx (t,x,y,r,i) < 0。对方程式(19)的左边关于π求导,并令其等于0可得
$$ \begin{gathered} V_x(t, x, y, r, i) x \mu_k(i)+ \\ V_{x x}(t, x, y, r, i) \pi x^2\left[\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\right. \\ \left.\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2\right]- \\ V_{x r}(t, x, y, r, i) x \sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right)=0, \end{gathered} $$ 则
$$ \pi^*(t, i)=-\frac{\mu_k(i) V_x(t, x, y, r, i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) V_{x r}(t, x, y, r, i)}{\left[\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2\right] x V_{x x}(t, x, y, r, i)} 。 $$ (20) 将π* (t,i) 的值代入式(19)中可得值函数V (t,x,y,r,i) 满足如下方程
$$ \begin{gathered} V_t(t, x, y, r, i)+V_r(t, x, y, r, i) a(b-r)+\frac{1}{2} V_{r r}(t, x, y, r, i) \sigma_r^2+V_x(t, x, y, r, i) x r(t)- \\ \frac{1}{2} \frac{\left[\mu_k(i) V_x(t, x, y, r, i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) V_{x r}(t, x, y, r, i)\right]^2}{\left[\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2\right] V_{x x}(t, x, y, r, i)}+ \\ V_x(t, x, y, r, i) c y+V_y(t, x, y, r, i) \mu_y(i) y+\frac{1}{2} V_{y y}(t, x, y, r, i) \delta^2(i) y^2+ \\ \sum\limits_{j=1}^N q_{i j}[V(t, x, y, r, j)-V(t, x, y, r, i)]=0, \end{gathered} $$ (21) 且边界条件为V (T,x,y,r,i) = U (x)。
综合定理2.1和上述计算,得到随机利率背景下考虑通货膨胀的养老金计划在效用函数为U (x) 时,当V (t,x,y,r,i) ∈ C1,2是上述式(19)HJB方程的1个解,且对任意的i ∈ [1,2,…,N]及t ∈ [0,T],满足Vx (t,x,y,r,i) > 0,Vx (t,x,y,r,i) < 0和增长条件:存在常数K > 0及整数k、l、m,使得|V (t,x,y,r,i)|≤ K (1 +|x|k +|y|l +|r|m),则该养老金计划的最优投资策略为式(20),最优值函数为式(21),终端边界条件为V (T,x,y,r,i) = U (x)。
3. 特殊效用函数下最优投资策略
考虑CARA效用函数,则养老金管理者的效应函数U (x) 满足
$$ U(x)=-\exp \{-\alpha x\}, $$ 式中α > 0是一个常数,表示养老金管理者的绝对风险厌恶系数。
3.1 常利率下考虑通胀的最优投资策略
定理3.1 在CARA效用的情况下,常数市场利率下考虑通货膨胀的养老金计划的最优投资策略为
$$ \pi^*(t, i)=\frac{\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r}{\alpha\left(\sigma(i)-\sigma_p(i)\right)^2 x \mathrm{e}^{r(T-t)}}, $$ (22) 最优值函数为
$$ \begin{aligned} V(t, x, y, i)=-\mathrm{e}^{-\alpha \mathrm{e}^{r(T-t)} x}E & {\left[\operatorname {exp} \left\{\int_t^T-\left[\frac{\left(\mu\left(\varepsilon_s\right)-\mu_p\left(\varepsilon_s\right)+\sigma_p^2\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right) \sigma\left(\varepsilon_s\right)-r\right)^2}{2\left(\sigma\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right)\right)^2}+\right.\right.\right.} \\ & \left.\left.\left.\alpha \mathrm{e}^{r(T-s)} c Y(s)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right\}\right], \end{aligned} $$ (23) 且V (T,x,y,i) = U (x) =- e- αx。
证明 首先假定式(14)解的形式为V (t,x,y,i) = - e- αm (t) x h (t,y,i),其中m (T) = 1和h (T,y,i) = 1。然后分别对V (t,x,y,i) 中时间t,财富x和工资y求一阶导数和二阶导数可得
$$ \begin{gathered} V_t(t, x, y, i)= \\ \alpha x m^{\prime}(t) \mathrm{e}^{-\alpha m(t) x} h(t, y, i)-\mathrm{e}^{-\alpha m(t) x} h_t(t, y, i), \\ V_x(t, x, y, i)=\alpha m(t) \mathrm{e}^{-\alpha x m(t)} h(t, y, i), \\ V_{x x}(t, x, y, i)=-\alpha^2 m^2(t) \mathrm{e}^{-\alpha x m(t)} h(t, y, i), \\ V_y(t, x, y, i)=-\mathrm{e}^{-\alpha x m(t)} h_y(t, y, i), \\ V_{y y}(t, x, y, i)=-\mathrm{e}^{-\alpha x m(t)} h_{y y}(t, y, i)。 \end{gathered} $$ 将Vx (t,x,y,i) = αm (t)e- αxm (t) h (t,y,i) 和Vxx (t,x,y,i) =- α2m2 (t)e- αxm(t) h (t,y,i) 代入式(15)得到养老金最优投资策略π* (t,i) =$\frac{\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r}{\alpha\left(\sigma(i)-\sigma_p(i)\right)^2 x m(t)}$,再将所有导数代入最优值函数中式(16)得
$$ \begin{gathered} \alpha x m^{\prime}(t) h(t, y, i)-h_t(t, y, i)+\alpha m(t) h(t, y, i) x r+ \\ \frac{1}{2} \frac{\left(\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r\right)^2 h(t, y, i)}{\left(\sigma(i)-\sigma_p(i)\right)^2}+ \\ \alpha m(t) h(t, y, i) c y- \\ h_y(t, y, i) b(i) y-\frac{1}{2} h_{y y}(t, y, i) \delta^2(i) y^2- \\ \sum\limits_j^N q_{i j}[h(t, y, j)-h(t, y, i)]=0 。 \end{gathered} $$ 从中提取2个等式(含x和不含x),并令其等于0,则
$$ \alpha x m^{\prime}(t) h(t, y, i)+\alpha m(t) h(t, y, i) x r=0, $$ (24) $$ \begin{gathered} -h_t(t, y, i)+ \\ \frac{1}{2} \frac{\left(\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r\right)^2 h(t, y, i)}{\left(\sigma(i)-\sigma_p(i)\right)^2}+ \\ \alpha m(t) h(t, y, i) c y- \\ h_y(t, y, i) b(i) y-\frac{1}{2} h_{y y}(t, y, i) \delta^2(i) y^2- \\ \sum\limits_j^N q_{i j}[h(t, y, j)-h(t, y, i)]=0 \text { 。 } \end{gathered} $$ (25) 对于式(24),根据边界条件m (T) = 1,算得m (t) = er(T-t)。结合上面的计算,得到养老金最优投资策略为$\pi^*(t, i)=\frac{\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r}{\alpha\left(\sigma(i)-\sigma_p(i)\right)^2 x \mathrm{e}^{r(T-t)}}$,满足式(22)。再将m (t) = er(T-t)代入式(25)中得
$$ \begin{gathered} -h_t(t, y, i)+ \\ \frac{1}{2} \frac{\left(\mu(i)-\mu_p(i)+\sigma_p^2(i)-\sigma_p(i) \sigma(i)-r\right)^2 h(t, y, i)}{\left(\sigma(i)-\sigma_p(i)\right)^2}+ \\ \alpha \mathrm{e}^{r(T-t)} h(t, y, i) c y- \\ h_y(t, y, i) b(i) y-\frac{1}{2} h_{y y}(t, y, i) \delta^2(i) y^2- \\ \sum\limits_j^N q_{i j}[h(t, y, j)-h(t, y, i)]=0。 \end{gathered} $$ (26) 为了求解此方程,对h (t,Y (t),εt)利用Itô公式可得
$$ \begin{gathered} \mathrm{d} h\left(t, Y(t), \varepsilon_t\right)=h_t\left(t, Y(t), \varepsilon_t\right) \mathrm{d} t+ \\ h_y\left(t, Y(t), \varepsilon_t\right) Y(t)\left[b\left(\varepsilon_t\right) \mathrm{d} t+\delta\left(\varepsilon_t\right) \mathrm{d} W_{2 t}\right]+ \\ \frac{1}{2} h_{y y}\left(t, Y(t), \varepsilon_t\right) \delta^2\left(\varepsilon_t\right) Y^2(t)+ \\ h\left(t, Y(t), \varepsilon_{t+}\right)-h\left(t, Y(t), \varepsilon_t\right) 。 \end{gathered} $$ (27) 将式(26)对t求导后与式(27)相加,可得
$$ \begin{gathered} \mathrm{d} h\left(t, Y(t), \varepsilon_t\right)=\frac{1}{2} \frac{\left(\mu\left(\varepsilon_t\right)-\mu_p\left(\varepsilon_t\right)+\sigma_p^2\left(\varepsilon_t\right)-\sigma_p\left(\varepsilon_t\right) \sigma\left(\varepsilon_t\right)-r\right)^2 h\left(t, Y(t), \varepsilon_t\right)}{\left(\sigma\left(\varepsilon_t\right)-\sigma_p\left(\varepsilon_t\right)\right)^2} \mathrm{~d} t+ \\ \alpha \mathrm{e}^{r(T-t)} h\left(t, Y(t), \varepsilon_t\right) c Y(t) \mathrm{d} t+h_y\left(t, Y(t), \varepsilon_t\right) Y(t) \delta\left(\varepsilon_t\right) \mathrm{d} W_{2 t}+h\left(t, Y(t), \varepsilon_{t+}\right)- \\ h\left(t, Y(t), \varepsilon_t\right)-\sum\limits_j^N q_{\varepsilon_t j}\left[h(t, Y(t), j)-h\left(t, Y(t), \varepsilon_t\right)\right] \mathrm{d} t。 \end{gathered} $$ 下一步对上式两边先求积分再关于Y (t) = y,εt = ei求条件期望可得
$$ \begin{gathered} E\left[h\left(T, Y(T), \varepsilon_T\right) \mid Y(t)=y, \varepsilon_t=e_i\right]=h(t, y, i)+ \\ E\left[\int _ { t } ^ { T } h ( s , Y _ { s } , \varepsilon _ { s } ) \left[\frac{1}{2} \frac{\left(\mu\left(\varepsilon_s\right)-\mu_p\left(\varepsilon_s\right)+\sigma_p^2\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right) \sigma\left(\varepsilon_s\right)-r\right)^2}{\left(\sigma\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right)\right)^2}+\right.\right. \\ \left.\left.\alpha \mathrm{e}^{r(T-s)} c Y(s)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]+E\left[\int_t^T h_y\left(s, Y_s, \varepsilon_s\right) Y(s) \delta\left(\varepsilon_s\right) \mathrm{d} W_{2 s} \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]+ \\ E\left[\sum\limits_{t \leqslant s \leqslant T}\left(h\left(s, Y_s, \varepsilon_{s+}\right)-h\left(s, Y_s, \varepsilon_s\right)\right) \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]- \\ E\left[\int_t^T \sum\limits_j^N q_{\varepsilon_s j}\left[h\left(s, Y_s, j\right)-h\left(s, Y_s, \varepsilon_s\right)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]。 \end{gathered} $$ 因为边界条件h (T,Y (T),εT) = 1,且根据连续时间Itô积分的性质$E \int_{T_0}^T f_t \mathrm{~d} W_t=0$,可得
$$ E\left[\int_t^T h_y\left(s, Y_s, \varepsilon_s\right) Y(s) \delta\left(\varepsilon_s\right) \mathrm{d} W_{2 s} \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]=0 。 $$ (28) 针对最后2个条件期望积分的结果,令Ji = $\int_t^T I_{\left\{\varepsilon_s=e_i\right\}} \mathrm{d} s$,表示马尔科夫链ε在时间[t,T] 内的累积逗留时间,其中I{·}是示性函数,则
$$ E\left[\int_t^T H\left(\varepsilon_s\right) \mathrm{d} s \mid \varepsilon_t=\boldsymbol{e}_i\right]=E\left[\sum\limits_{i=1}^N H(i) J_i \mid \varepsilon_t=\boldsymbol{e}_i\right] 。 $$ 故
$$ \begin{gathered} E\left[\sum\limits_{t \leqslant s \leqslant T}\left(h\left(s, Y_s, \varepsilon_{s+}\right)-h\left(s, Y_s, \varepsilon_s\right)\right) \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]- \\ E\left[\int_t^T \sum\limits_j^N q_{\varepsilon_s j}\left[h\left(s, Y_s, j\right)-h\left(s, Y_s, \varepsilon_s\right)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]=0。 \end{gathered} $$ (29) 综合上述计算,
$$ \begin{gathered} h(t, y, i)=1-E\left[\int _ { t } ^ { T } h ( s , Y _ { s } , \varepsilon _ { s } ) \left[\frac{1}{2} \frac{\left(\mu\left(\varepsilon_s\right)-\mu_p\left(\varepsilon_s\right)+\sigma_p^2\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right) \sigma\left(\varepsilon_s\right)-r\right)^2}{\left(\sigma\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right)\right)^2}+\right.\right. \\ \left.\left.\alpha \mathrm{e}^{r(T-s)} c Y(s)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]= \\ E\left[\operatorname {exp} \left\{-\frac{1}{2} \frac{\left(\mu\left(\varepsilon_s\right)-\mu_p\left(\varepsilon_s\right)+\sigma_p^2\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right) \sigma\left(\varepsilon_s\right)-r\right)^2}{\left(\sigma\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right)\right)^2}+\right.\right. \\ \left.\left.\left.\alpha \mathrm{e}^{r(T-s)} c Y(s)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right\}\right], \end{gathered} $$ 则最优值函数为
$$ \begin{gathered} V(t, x, y, i)=-\mathrm{e}^{-\alpha \mathrm{e}^{r(T-t)} x} E\left[\operatorname {exp} \left\{\int_t^T-\left[\frac{\left(\mu\left(\varepsilon_s\right)-\mu_p\left(\varepsilon_s\right)+\sigma_p^2\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right) \sigma\left(\varepsilon_s\right)-r\right)^2}{2\left(\sigma\left(\varepsilon_s\right)-\sigma_p\left(\varepsilon_s\right)\right)^2}+\right.\right.\right. \\ \left.\left.\left.\alpha \mathrm{e}^{r(T-s)} c Y(s)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right\}\right]。 \end{gathered} $$ 式(23)得证。
由于h(t,y,i)恒大于0且α > 0,则Vx (t,x,y,r,i) > 0,Vxx (t,x,y,r,i) < 0,并且V(t,x,y,i)符合增长条件,故其为式(16)的解。
3.2 随机利率下考虑通胀的最优投资策略
定理3.2 在CARA效用函数下,随机利率背景下考虑通货膨胀的养老金计划的最优投资策略为
$$ \begin{gathered} \pi^*(t, i)= \\ \frac{\mu_k(i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) \frac{c\left(1-\mathrm{e}^{-a(T-t)}\right)}{a}}{\alpha\left[\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2\right] x \mathrm{e}^{\int_t^T r(s) \mathrm{d} s}}, \end{gathered} $$ (30) 最优值函数为
$$ \begin{gathered} V(t, x, y, r, i)= \\ -\mathrm{e}^{-\alpha m(t) x+g(t) r} E\left[\operatorname {exp} \left\{\int_t^T-\left[-a b g(s)+c r-\frac{1}{2} \sigma_r^2 g^2(s)+\right.\right.\right. \\ \frac{1}{2} \frac{\left[\mu_k\left(\varepsilon_s\right)-\sigma_r\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right) g(s)\right]^2}{\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right)^2+\left(\sigma_2\left(\varepsilon_s\right)-\sigma_{p 2}\left(\varepsilon_s\right)\right)^2}+ \\ \left.\left.\alpha m(s) c Y(s)] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right\}\right], \end{gathered} $$ (31) 式中$m(t)=\mathrm{e}^{\int_t^T r(s) \mathrm{d} s}$,满足边界条件m(T)=1,g (t) =$\frac{c\left(1-\mathrm{e}^{-a(T-t)}\right)}{a}$且满足边界条件g(T) = 0,
$$ \begin{gathered} \mu_k(i)=\sigma_1(i) \lambda_r(i)+\sigma_2(i) \lambda_s(i)-\mu_p(i)+\sigma_{p 1}^2(i)+ \\ \sigma_{p 2}^2(i)-\sigma_{p 1}(i) \sigma_1(i)-\sigma_{p 2}(i) \sigma_2(i) 。 \end{gathered} $$ 证明 首先猜测式(19)解的形式为V (t,x,y,r,i) =- e- αm(t)x+g(t)r h (t,y,i),式中m (T) = 1、g (T) = 0、h (T,y,i) = 1。分别对V (t,x,y,r,i) 中时间t,随机利率r,财富x和工资y求一阶导数、二阶导数和混合导数可得
$$ \begin{gathered} V_t(t, x, y, r, i)=\left(\alpha x m^{\prime}(t)-\right. \\ \left.g^{\prime}(t) r\right) \mathrm{e}^{-\alpha m(t) x+g(t) r} h(t, y, i)-\mathrm{e}^{-\alpha m(t) x+g(t) r} h_t(t, y, i), \\ V_r(t, x, y, r, i)=-g(t) \mathrm{e}^{-\alpha m(t) x+g(t) r} h(t, y, i), \\ V_{r r}(t, x, y, r, i)=-g^2(t) \mathrm{e}^{-\alpha x m(t)+g(t) r} h(t, y, i), \\ V_{x r}(t, x, y, r, i)=\alpha m(t) g(t) \mathrm{e}^{-\alpha m(t) x+g(t) r} h(t, y, i), \\ V_y(t, x, y, r, i)=-\mathrm{e}^{-\alpha x m(t)+g(t) r} h_y(t, y, i), \\ V_{y y}(t, x, y, r, i)=-\mathrm{e}^{-\alpha x m(t)+g(t) r} h_{y y}(t, y, i) 。 \end{gathered} $$ 将Vx (t,x,y,r,i) = αm (t)e- αm (t)x+g(t) r h (t,y,i)、Vxx (t,x,y,r,i) =- α2m2 (t)e- αxm(t)+g(t) r h (t,y,i) 以及Vxr (t,x,y,r,i) = αm (t) g (t)e- αm(t)x+g(t) r h (t,y,i) 代入式(19)中可得本模型下养老金计划的最优投资策略$\pi^*(t, i)=\frac{\mu_k(i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) g(t)}{\alpha\left[\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2\right] x m(t)}$,再将所有导数代入最优值函数式(21)中并进行整理化简得
$$ \begin{gathered} \left(\alpha x m^{\prime}(t)-r g^{\prime}(t)\right) h(t, y, i)-h_t(t, y, i)- \\ g(t) a(b-r) h(t, y, i)-\frac{1}{2} g^2(t) \sigma_r^2 h(t, y, i)+ \\ \alpha m(t) x r h(t, y, i)+ \\ \frac{1}{2} \frac{\left[\mu_k(i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) g(t)\right]^2 h(t, y, i)}{\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2}+ \\ \alpha m(t) c y h(t, y, i)- \\ \mu_y(i) y h_y(t, y, i)-\frac{1}{2} \delta^2(i) y^2 h_{y y}(t, y, i)- \\ \sum\limits_j^N q_{i j}[h(t, y, j)-h(t, y, i)]=0。 \end{gathered} $$ 从中提取3个等式,令其等于0。
$$ \alpha x m^{\prime}(t) h(t, y, i)+\alpha m(t) {xrh}(t, y, i)=0, $$ (32) $$ -r g^{\prime}(t) h(t, y, i)+g(t) {arh}(t, y, i)-{crh}(t, y, i)=0, $$ (33) $$ \begin{gathered} -h_t(t, y, i)-g(t) a b h(t, y, i)+{crh}(t, y, i)- \\ \frac{1}{2} g^2(t) \sigma_r^2 h(t, y, i)+ \\ \frac{1}{2} \frac{\left[\mu_k(i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) g(t)\right]^2 h(t, y, i)}{\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2}+ \\ \alpha m(t) c y h(t, y, i)- \\ \mu_y(i) y h_y(t, y, i)-\frac{1}{2} \delta^2(i) y^2 h_{y y}(t, y, i)- \\ \sum\limits_j^N q_{i j}[h(t, y, j)-h(t, y, i)]=0, \end{gathered} $$ (34) 对于式(32),由于m (T) = 1,解得m (t) =$\mathrm{e}^{\int_t^T r(s) \mathrm{d} s}$。而对于式(33),由于g (T) = 0,可知g (t) = $\frac{c\left(1-\mathrm{e}^{-a(T-t)}\right)}{a}$。先将m(t)和g(t)代入最优投资策略中,得到
$$ \begin{gathered} \pi^*(t, i)= \\ \frac{\mu_k(i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) \frac{c\left(1-\mathrm{e}^{-a(T-t)}\right)}{a}}{\alpha\left[\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2\right] x \mathrm{e}^{\int_t^T r(s) \mathrm{ds}}}, \end{gathered} $$ 式(30)得证。再将m(t)和g(t)代入式(34)中,得到
$$ \begin{gathered} -h_t(t, y, i)-b c\left(1-\mathrm{e}^{-a(T-t)}\right) h(t, y, i)+c r h(t, y, i)-\frac{c^2}{2 a^2}\left(1-\mathrm{e}^{-a(T-t)}\right)^2 \sigma_r^2 h(t, y, i)+ \\ \frac{1}{2} \frac{\mu\left[{ }_k(i)-\sigma_r\left(\sigma_1(i)-\sigma_{p 1}(i)\right) \frac{c\left(1-\mathrm{e}^{-a(T-t)}\right)}{a}\right]^2 h(t, y, i)}{\left(\sigma_1(i)-\sigma_{p 1}(i)\right)^2+\left(\sigma_2(i)-\sigma_{p 2}(i)\right)^2}+\alpha c y \mathrm{e}^{\int_{t}^Tr(s) \mathrm{d} s} h(t, y, i)- \\ \mu_y(i) y h_y(t, y, i)-\frac{1}{2} \delta^2(i) y^2 h_{y y}(t, y, i)-\sum\limits_j^N q_{i j}[h(t, y, j)-h(t, y, i)]=0 。 \end{gathered} $$ (35) 与3.1节方法相同,利用对h (t,Y (t),εt) 的Itô公式可得式(27),与式(35)相结合进行计算,并同样的根据边界条件h (T,Y (T),εT) = 1以及式(28)和(29),综合计算后,得到
$$ \begin{aligned} h(t, y, i) & =1-E\left[\int _ { t } ^ { T } \left[-b c\left(1-\mathrm{e}^{-a(T-s)}\right)+c r-\frac{c^2}{2 a^2} \sigma_r^2\left(1-\mathrm{e}^{-a(T-s)}\right)^2+\alpha \mathrm{e}^{\int_s^T r(m) \mathrm{d} m} c Y(s)+\right.\right. \\ & {\left.\left.\left.\frac{\left[\mu_k\left(\varepsilon_s\right)-\sigma_r\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right) \frac{c\left(1-\mathrm{e}^{-a(T-s)}\right)}{a}\right]^2}{2\left[\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right)^2+\left(\sigma_2\left(\varepsilon_s\right)-\sigma_{p 2}\left(\varepsilon_s\right)\right)^2\right]}\right] \mathrm{d} s \right\rvert\, Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right]=} \\ E & {\left[\operatorname {exp} \left\{\int_t^T-\left[-b c\left(1-\mathrm{e}^{-a(T-s)}\right)+c r-\frac{c^2}{2 a^2} \sigma_r^2\left(1-\mathrm{e}^{-a(T-s)}\right)^2+\alpha \mathrm{e}^{\int_s^T r(m) d m} c Y(s)+\right.\right.\right.} \\ & {\left.\left.\left.\left.\frac{\left[\mu_k\left(\varepsilon_s\right)-\sigma_r\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right) \frac{c\left(1-\mathrm{e}^{-a(T-s)}\right)}{a}\right]^2}{2\left[\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right)^2+\left(\sigma_2\left(\varepsilon_s\right)-\sigma_{p 2}\left(\varepsilon_s\right)\right)^2\right]}\right] \mathrm{d} s \right\rvert\, Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right\}\right] }, \end{aligned} $$ 则最优值函数为
$$ \begin{array}{c} V(t, x, y, r, i)= \\ -\mathrm{e}^{-a \mathrm{e}^{\int_t^Tr(s) \mathrm{d} s}+\frac{c\left(1-\mathrm{e}^{-a(T-t)}\right)}{a} r} E\left[\operatorname {exp} \left\{\int_t^T-\left[-b c\left(1-\mathrm{e}^{-a(T-s)}\right)+c r-\frac{c^2}{2 a^2} \sigma_r^2\left(1-\mathrm{e}^{-a(T-s)}\right)^2+\right.\right.\right. \\ \left.\left.\left.\frac{\left[\mu_k\left(\varepsilon_s\right)-\sigma_r\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right) \frac{c\left(1-\mathrm{e}^{-a(T-s)}\right)}{a}\right]^2}{2\left[\left(\sigma_1\left(\varepsilon_s\right)-\sigma_{p 1}\left(\varepsilon_s\right)\right)^2+\left(\sigma_2\left(\varepsilon_s\right)-\sigma_{p 2}\left(\varepsilon_s\right)\right)^2\right]}+\alpha \mathrm{e}^{\int_s^T r(m) \mathrm{d} m} c Y(s)\right] \mathrm{d} s \mid Y(t)=y, \varepsilon_t=\boldsymbol{e}_i\right\}\right] 。 \end{array} $$ 式(31)得证。
易证对任意的i ∈ [1,2,…,N] 及t ∈ [0,T],其结果满足Vx (t,x,y,r,i) > 0,Vx (t,x,y,r,i) < 0和增长条件:存在常数K > 0及整数k、l、m,使得|V (t,x,y,r,i)|≤ K (1 +|x|k +|y|l+|r|m),故其为式(19)的解。
4. 数值分析
4.1 常利率下考虑通货膨胀的最优投资策略分析
本节在CARA效用函数下,考虑市场行情看涨的股市(简称牛市)和市场行情看跌的股市(简称熊市)2种市场经济状态。在市场经济状态较好的情况下,金融资产具有较高的市场回报率和相对较低的波动率,无风险利率会相对较低;而在市场经济状态较差的情况下,金融资产的投资收益较低,但是波动率较高,金融市场十分不稳定,熊市的无风险利率相对较高。为了便于分析通货膨胀的影响,根据博德等[17]和陈源[18]的研究,当通货膨胀处于较低位的时候,市场多为繁荣,当通货膨胀率持续上升时,股票市场也相对走向萧条。对此,假设在牛市情况下,通货膨胀折扣率较低,在熊市的情况下,通货膨胀折扣率较高。本节模型中使用的参数设定如表 1所示。
表 1 模型中参数值经济状态 市场利率 初始财富 预期回报率 预期波动率 通货膨胀率 通货膨胀波动率 年限 牛市 0.05 10 0.10 0.2 0.003 0.3 20 熊市 0.06 10 0.06 0.4 0.006 0.3 20 注:牛市指市场行情看涨的股市; 熊市指市场行情看跌的股市。 假设α=0.4。针对2种不同市场状态下牛市和熊市的养老金最优投资策略π*作出关于时间t的变化如图 1所示。在养老金投资时限20年中,对于市场经济状态良好的牛市,由于市场风险溢价为正,养老金管理者偏向于投资风险资产,且随着时间的推移,其投入的比例逐年增加,初始约74.40% 的资金投资于股票市场;对于市场经济状态较差的熊市,养老金管理者选择卖空风险资产,投资无风险资产,利用更稳妥的方式获取收益。
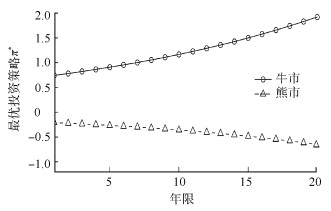 图 1 不同市场状态下最优投资策略随时间的变化
 下载:
全尺寸图片
不同市场状态下(牛市和熊市)市场利率和绝对风险厌恶系数对于养老金最优投资策略的影响如图 2所示。考虑牛市的市场环境下,养老金计划的管理者随着市场利率r的增大,对于风险资产的投资比例越来越少,趋向于0。其原因在于随着市场利率r的增加,购买无风险资产的收益增加。由于养老金管理者是风险厌恶型的,且随着购买无风险的收益率逐渐提高,慢慢地接近风险资产收益率,因此养老金管理者更倾向于购买风险较低的无风险资产。对于绝对风险厌恶系数而言,随着α的增大,养老金管理者对于风险的承受能力下降,更加厌恶风险。因此,养老金管理者选择投资风险资产的比例减小。考虑熊市的市场环境,市场利率对于养老金最优投资策略具有负面影响,即市场利率的增加会导致养老金管理者投资于风险资产的比例下降。由于通货膨胀的存在,在市场利率较低的环境,管理者仍会投资一部分风险资产来弥补无风险资产收益较低的情况。当市场利率r > 0.024时,风险溢价为负,养老金管理者选择卖空风险资产,买入更多的无风险资产。对于绝对风险系数,当随机利率r < 0.024,随着α的增大,投资于更少的风险资产;当r > 0.024,由于卖空风险资产同样具有风险,养老金管理者在较高的绝对风险系数α下,会选择卖空较少的风险资产,以此来规避金融市场的波动。
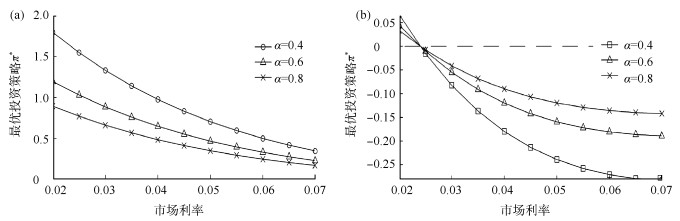 图 2 不同状态下市场利率和风险厌恶系数最优投资策略的影响 (a)牛市;(b)熊市下载:
全尺寸图片
不同预期通货膨胀率下的养老金最优投资策略的变化如图 3所示。预期通货膨胀率对于养老金的最优投资策略影响较小。随着预期通货膨胀率的升高,养老金管理者对于风险资产的投资略有下降。随着通货膨胀率的增高,市场经济形势会变得不稳定,投资风险市场收益的不确定性增加,导致管理者对股票的兴趣下降。但是整体来看,由于在牛市的情况下,风险资产的收益率高于无风险资产的收益率,故在不同预期通货膨胀率下,养老金管理者还是会将大部分资产投入到风险资产中。
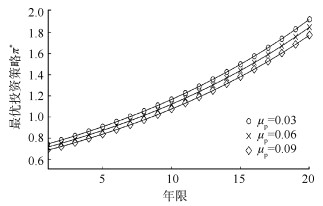 图 3 不同预期通货膨胀率下的养老金最优投资策略的变化下载:
全尺寸图片
4.2 随机利率下考虑通货膨胀的最优投资策略分析
本节在CARA效用函数下,探究随机利率下考虑通货膨胀的养老金最优投资策略与时间t的关系。由于最优投资策略是随机的,故利用生成随机数的方法寻找最优投资策略的平均比例。其中对于随机利率r(t)的处理参考Guan和Liang[9]的引理A.1,得到r (t) ~N (e- at r (0) + b (1 - e-at),$\left.\frac{\sigma_r^2}{2 a}\left(1-\mathrm{e}^{-2 a t}\right)\right)$,此外$\int_t^T r(s) \mathrm{d} s \sim N\left((r(t)-b) \frac{1-\mathrm{e}^{-a(T-t)}}{a}+b(T-t)\right.$,$\left.\frac{\sigma_r^2}{a^2}\left[(T-t)+\frac{2 \mathrm{e}^{-a(T-t)}}{a}-\frac{\mathrm{e}^{-2 a(T-t)}}{2 a}-\frac{3}{2 a}\right]\right)$,利用其正态分布的特征来模拟积分的值。本节使用的模型参数如表 2所示。此外,假设常数a、b、σr分别为0.15、0.04、0.015,工资缴费率为0.14,初始财富为10,投资年限为20,风险厌恶示数为0.4。
表 2 模型中的参数值-1经济状态 正常数σ1 正常数σ2 利率风险价格 市场风险价格 通胀率 通胀波动率1 通胀波动率2 牛市 0.1 0.3 0.15 0.200 0.003 0.2 0.2 熊市 0.3 0.4 0.15 0.005 0.006 0.2 0.2 随机利率市场下的不同经济状态的养老金最优投资策略在投资期限内的变化情况如图 4所示。与图 1中所展示的变化趋势相同的是,在牛市市场状态下,由于风险资产投资收益很高,养老金管理者偏向于在股票市场势头旺盛时购入大量风险资产,以此来获取更多的收益;而在熊市情况下,管理者同样采取了卖空风险资产的策略,买入更多的无风险资产。值得注意的是,在随机利率市场下,由于利率的不确定性,导致投资策略不是平滑增长或下降的,而是具有波动性,但整体趋势仍是牛市买入的风险资产比例增多,熊市买入的无风险资产比例上升。
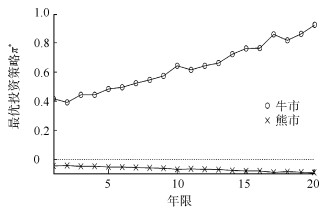 图 4 随机利率下不同市场状态的最优投资策略随时间的变化下载:
全尺寸图片
5. 结束语
本文以马尔科夫机制转换模型为基础,综合考虑多因素影响下的养老金最优投资问题,主要分为常数市场利率和随机利率下带通货膨胀的养老金问题2部分。数值结果显示,在此2种模型的养老金问题中,牛市状态下,市场风险溢价为正,养老金管理者选择持续买入风险资产;熊市的环境下,养老金管理者选择卖空风险资产;随机利率环境下投资比例的变化曲线不平滑,存在一定的波动性。在不同环境下,市场利率r和绝对风险厌恶系数α对于养老金风险资产的投资比例均具有负面影响,且在不同的经济状态下,养老金管理者具有不同的投资策略。预期通货膨胀率对于养老金最优投资策略的影响较小,随着通货膨胀风险的增加,金融市场的不确定性增加,养老金管理者投资于风险资产的比例略有下降。研究表明,市场经济状态影响养老金管理者的投资策略,且探究市场环境中不同因素的影响能更合理地为养老金管理者的决策提供思路。
-
图 1 不同市场状态下最优投资策略随时间的变化
下载:
全尺寸图片
图 2 不同状态下市场利率和风险厌恶系数最优投资策略的影响 (a)牛市;(b)熊市
下载:
全尺寸图片
图 3 不同预期通货膨胀率下的养老金最优投资策略的变化
下载:
全尺寸图片
图 4 随机利率下不同市场状态的最优投资策略随时间的变化
下载:
全尺寸图片
表 1 模型中参数值
经济状态 市场利率 初始财富 预期回报率 预期波动率 通货膨胀率 通货膨胀波动率 年限 牛市 0.05 10 0.10 0.2 0.003 0.3 20 熊市 0.06 10 0.06 0.4 0.006 0.3 20 注:牛市指市场行情看涨的股市; 熊市指市场行情看跌的股市。 表 2 模型中的参数值-1
经济状态 正常数σ1 正常数σ2 利率风险价格 市场风险价格 通胀率 通胀波动率1 通胀波动率2 牛市 0.1 0.3 0.15 0.200 0.003 0.2 0.2 熊市 0.3 0.4 0.15 0.005 0.006 0.2 0.2 -
[1] MERTON R. Optimal consumption and portfolio rules in a continuous-time model[J]. Journal of Economic Theory, 1971, 3(4): 373-413. doi: 10.1016/0022-0531(71)90038-X [2] BOULIER J, HUANG S J, TAILLARD G. Optimal management under stochastic interest rates: the case of a protected defined contribution pension fund[J]. Insurance Mathematics Economics, 1971, 28(2): 173-189. http://www.onacademic.com/detail/journal_1000034176980410_4b53.html [3] GAO J W. Optimal portfolios for DC pension plans under a CEV model[J]. Insurance (Mathematics and Economics), 2009, 44: 479-490. doi: 10.1016/j.insmatheco.2009.01.005 [4] BATTOCCHIO P, MENONCIN F. Optimal pension management in a stochastic framework[J]. Insurance: Mathematics and Economics, 2004, 34(1): 79-95. doi: 10.1016/j.insmatheco.2003.11.001 [5] 殷俊, 李媛媛. 基于随机利率和通货膨胀的缴费确定型养老金计划最优资产配置策略[J]. 当代经济科学, 2013, 35(2): 11-21. [6] 费为银, 李允贺, 夏登峰. 通胀下带激励的对冲基金最优投资[J]. 系统工程理论与实践, 2015, 35(11): 2740-2748. [7] BALTAS I, DOPIERALA L, KOLODZIEJCZYK K, et al. Optimal management of defined contribution pension funds under the effect of inflation, mortality and uncertainty[J]. European Journal of Operational Research, 2022, 298(3): 1162-1174. doi: 10.1016/j.ejor.2021.08.038 [8] 张初兵, 荣喜民. 仿射利率模型下确定缴费型养老金的最优投资[J]. 系统工程理论与实践, 2012, 32(5): 1048-1056. [9] GUAN G H, LIANG Z X. Optimal management of DC pension plan under loss aversion and Value-at-Risk constraints[J]. Insurance Mathematics and Economics, 2016, 69: 224-237. doi: 10.1016/j.insmatheco.2016.05.014 [10] 吴津津, 王传玉, 张静. 随机利率和通货膨胀下DC养老金的鲁棒最优投资策略[J]. 重庆工商大学学报(自然科学版), 2020, 37(1): 95-103. [11] HAMILTON J. A new approach to the economic analysis of non-stationary time series[J]. Econometrica, 1989, 57: 357-384. doi: 10.2307/1912559 [12] YAO D J, QIAN L Y, CHENG G P. Best investment strategy under regulatory risk model: maximizing terminal utility[J]. Application Probability Statistics, 2013, 29(3): 317-329. [13] 甘少波, 王伟, 王文胜. 马尔可夫机制转换模型下确定缴费型养老金计划的最优投资策略[J]. 数学的实践与认识, 2016, 46(22): 97-104. [14] KORN R, SIU T, ZHANG A H. Asset allocation for a DC pension fund under regime switching environment[J]. European Actuarial Journal, 2011, 1: 361-377. doi: 10.1007/s13385-011-0021-5 [15] 王传玉, 付春艳, 盛国祥. 基于通货膨胀和最低保障的DC养老金最优投资[J]. 运筹与管理, 2018, 27(2): 193-199. [16] BÄUERLE N, RIEDER U. Portfolio optimization with Markov-modulated stock prices and interest rates[J]. IEEE Transactions on Automatic Control, 2004, 49(3): 442-447. doi: 10.1109/TAC.2004.824471 [17] 博德M D, 杜克尔M J, 惠洛克D C, 等. 20世纪的货币政策与股票市场兴衰[J]. 经济社会体制比较, 2008, (3): 33-41. [18] 陈源. 通货膨胀与股票市场作用机制研究[J]. 统计与决策, 2013(23): 155-158.
