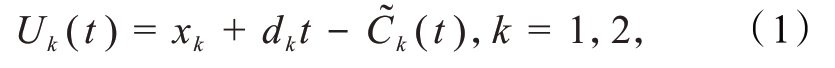
Non-zero-sum stochastic differential game under the Heston investment model*
在实际中,保险行业发展形势一片大好的背后,保险公司之间往往存在着异常激烈的竞争,竞争对手的战略布局无疑会影响自身的决策和反应。同时,随着新型冠状病毒肺炎疫情在全球的蔓延,保险公司也在遭受着来自外部市场环境不确定性的考验。因此在研究保险公司的最优投资策略选择问题时,从竞争对手和市场环境2 个角度同时考虑才更符合实际,该问题就属于随机微分博弈问题。
保险精算领域中的随机微分博弈问题大多研究在不同的目标函数和模型准则下考虑2 家保险公司之间的零和博弈或非零和博弈,并找到相关的纳什均衡策略。如:Sid[1]研究了带有单一支付函数的投资者之间的零和博弈;罗琰和杨招军[2]研究了基于保险公司与市场二者之间的最优投资及再保险零和博弈;Taksar 和Zeng[3]研究了保险公司购买非比例再保险情况下的零和博弈;Bensoussan 等[4]开辟了非零和博弈的先河,构建了一种状态转移跳扩散模型下的再保险与投资博弈;Zhang 等[5]进一步研究了在非零和博弈框架下保险公司的注资问题;Meng 等[6]研究了非线性风险下具有再保险业务的非零和博弈;Campi 和Santis[7]运用拟变分不等式研究了具有脉冲控制和可随时停止的非零和博弈。
在实际中,保险公司的决策者大多是模糊厌恶者,即对于模型不确定性持反对态度。目前通常采用Girsanov 变换,引入一族概率测度来研究模型不确定性,如:Cairns[8]讨论了一种将参数不确定性与模型不确定性结合在一起的方法,结果表明加入不确定性对结果有很大的贡献;刘兵和周明[9]在金融市场存在模糊性的情况下,研究了保险公司的最优投资和最优保费策略;Pun 和Wong[10]在博弈问题中,建立了模型不确定性下非零和博弈的一般框架;Wang 等[11]在Pun 和Wong[10]的基础上,研究了具有违约风险的2 个模糊厌恶的保险公司之间的非零和博弈问题。
此外,考虑一般的金融市场,假设股票价格的动态过程遵循Heston 随机波动模型,该模型认为股票波动率会随价格变化而变化,并且还考虑了波动率与标的资产价格回报之间的相关性。在此模型下:杨璐等[12]研究了带有期权的资产负债管理模型;Deng 等[13]研究了具有违约风险的再保险与投资非零和博弈问题。
以上研究表明现阶段有关模型不确定性下的非零和博弈问题还处于发展阶段,而在Heston 投资模型下的研究更是少有,因此,本文基于Wang 等[11]和Deng 等[13]的研究结果,研究在Heston 随机波动模型下,模糊厌恶型保险公司之间的非零和随机微分博弈问题。
设(Ω,Ft,ℙ)为一个满足通常条件的完备概率空间,{Ft,0≤t≤T} 代表到t 时刻所获取的市场信息总和,ℙ 为完备的概率测度。假定股票和债券在有限时间区间[0,T]内是可交易的,T 指最终交易时间,并且允许连续交易,交易不涉及交易成本及税收,所有资产都是无限可分的。
假设第k 家保险公司的盈余过程为
式中:xk∈R 表示初始盈余,dk 表示保费率, (t)表示到t 时刻为止的累计索赔。假设
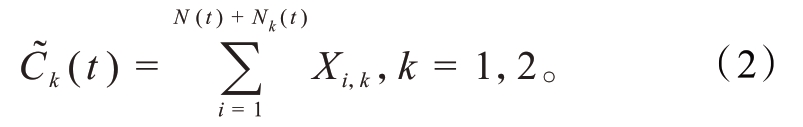
对于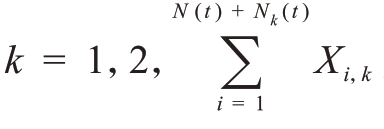 是定义在(Ω,Ft,ℙ) 上的复合Poisson 过程,{N(t),t≥0}、{N1(t),t≥0}、{N2(t),t≥0}是相互独立的齐次Poisson 过程,强度依次为λ、λ1、λ2>0,分别表示2 家保险公司的交叉业务和独立业务到t 时刻为止的索赔次数。{Xi,k}i≥0 是独立同分布的随机变量,表示第k 家保险公司第i 次的索赔额,其分布为Fk(x),一阶原点矩为μk=E[Xi,k],二阶原点矩为μkk=E[(Xi,k)2]。
参考Schmidli[14],将索赔过程 (t)近似为带漂移的布朗运动,满足
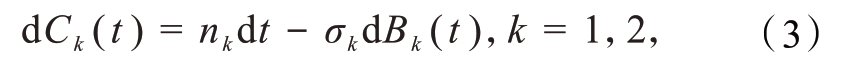
式中:nk=(λ+λk)μk>0,σk=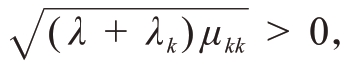 {Bk(t),0≤t≤T}为(Ω,Ft,ℙ)下的标准布朗运动,且B1(t)、B2(t)存在相关性,相关系数为ρ∈[-1,1],即cov(B1(t),B2(t))=ρt。
对保险公司来说,通过再保险可以有限分散巨额索赔风险,假设2 家保险公司同时购买比例再保险以降低风险。设qk(t)∈[]0,1,k=1,2,表示第k家保险公司在t 时刻购买比例再保险后的风险自留比例,Qk≜{qk(t)|0<qk<1},k=1,2,表示第k 家保险公司再保险策略集合。对于k=1,2,第k 家保险公司购买再保险后的盈余过程Ukqk(t)可表示为
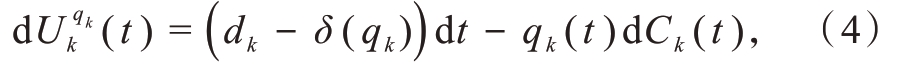
式中:δ(qk)表示第k 家保险公司的再保费率,假设按期望保费原则计算再保费,则有
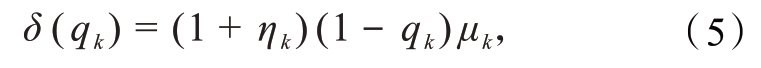
ηk>0 表示第k 家保险公司再保险的安全负荷,将式(3)代入式(4)得
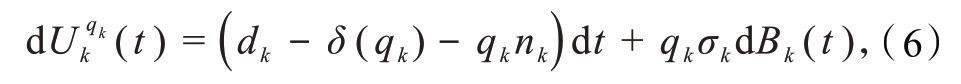
且Ukqk(0)=xk。
不失一般性,假设保险公司可以同时投资于1 个无风险市场(债券)和1 个有风险市场(股票),设无风险市场的价格过程为
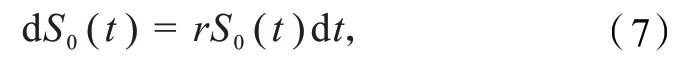
式中:S0(0)=s0>0,r>0 为无风险利率。有风险市场(股票)的价格过程由Heston 随机波动率模型来刻画,这一模型将股票价格的波动率描述为一个由长期均值、均值回归速度和方差波动率(即波动率的波动率)控制的随机过程。这样可对波动率的变化进行动态刻画,从而使股票的价格过程更加贴近真实市场。价格过程为
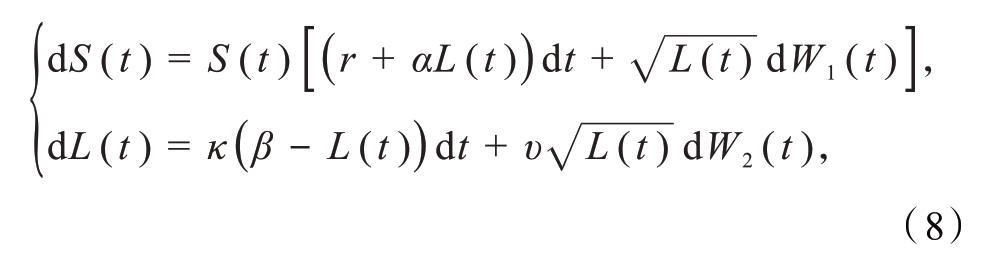
式中:L(t)是一个随机过程,表示股票价格波动的方差,且满足L(0)=l>0、S(0)=s>0;α、κ、β、υ为正常数,分别代表波动率均值、均值回归速度、长期均值和股票方差波动率。参考Cox 等[15]的研究,这里假设2κβ>υ2 以保证L(t)是严格的正数。此外,W1(t)、W2(t)为(Ω,Ft,ℙ)下的标准布朗运动,且cov(W1(t),W2(t))= t,∈[-1,1]代表股票价格和股票方差之间的相关系数。
假设第k 家保险公司在t时刻投资在风险市场上的资金量θk(t),Θk≜{θk(t)} 表示第k 家保险公司投资策略的集合,k=1,2。记πk(t)≜(qk(t),θk(t))为第k 家保险公司选择的交易策略,因此,保险公司在t 时刻基于交易策略πk 下的盈余过程Zkπk(t)为
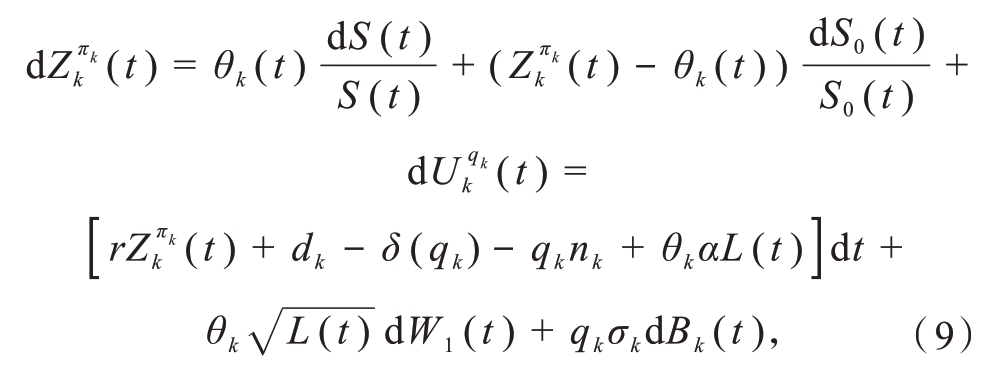
式中:Zkπk(0)=xk;k=1,2。
定义1.1 对于t∈[0,T],第k 家保险公司的交易策略πk(t)=(qk(t),θk(t)),k=1,2 称为可行策略,如果满足:
(1)(qk(t),θk(t)) 为 Ft 循序可测的,且∀t∈[0,T];
(2)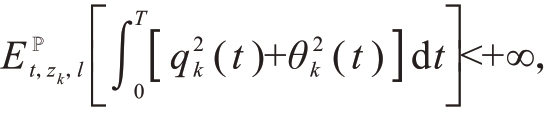 这里
 [·]=Eℙ[·|Zkπk(t)=zk,L(t)=l];
(3)随机微分方程(9)有唯一强解。
所有可行策略的集合用Πk 表示,k=1,2。
上述模型建立在概率测度ℙ 下进行,实际情况中,保险公司对概率测度ℙ 具有模糊厌恶态度。保险公司只将ℙ 作为参考测度,希望考虑一组可选的概率测度,定义了一类等价于ℙ 的概率测度作为替代测度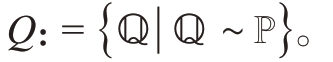
构造 ℚk∈Q 如下:设φk(t):=(φk,1(t),φk,2(t),φk,3(t)),k=1,2,为一组{Ft} t∈[0,T]适应过程,满足:
(1)φk,1(t),φk,2(t),φk,3(t)为[0,T]上Ft 循序可测函数;
(2)φk,1(t),φk,2(t),φk,3(t)>0,对(t,w)∈[0,T]×Ω几乎处处成立;
(3)φk,1(t),φk,2(t),φk,3(t)满足Novikov 条件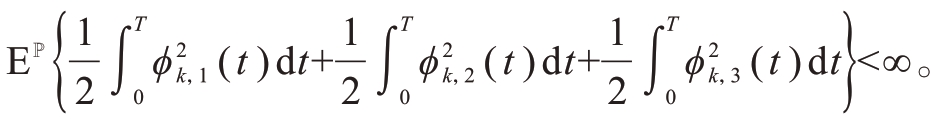
记满足以上条件的过程{φk(t),0≤t≤T},k=1,2,构成的集合为Φ。
由Girsanov 定理[16],∀ℚk∈Q,都存在与之对应的φk(t)使得
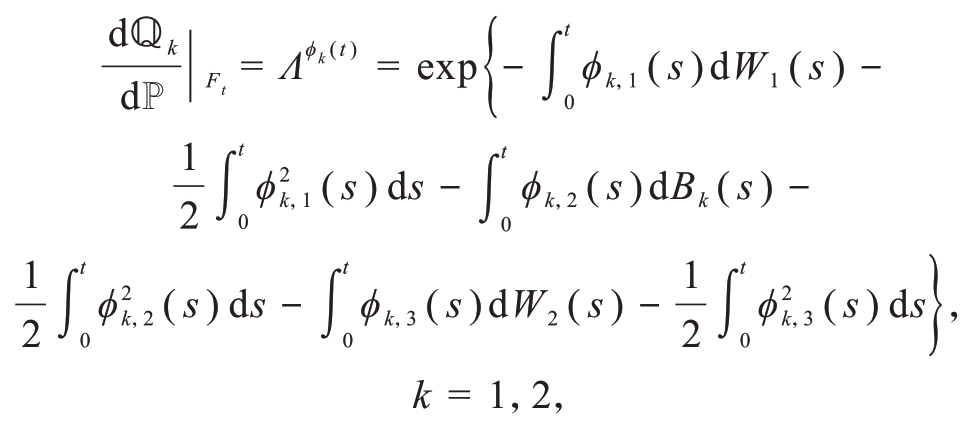
在概率测度ℚk 下,W1ℚ(t)、Bℚk(t)、W2ℚ(t)均为标准布朗运动,应满足:
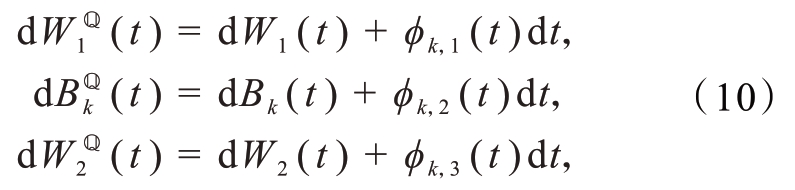
式中:k=1,2;Bℚ1(t)、Bℚ2(t)、W1ℚ(t)、W2ℚ(t)相互独立,W1ℚ(t)、W2ℚ(t) 依旧具有一定相关性,满足cov(W1ℚ(t),W2ℚ(t))=t,∈[-1,1]。
记KL(ℙ‖ℚk)=Eℚk[ln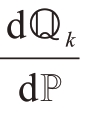 ]≥0 为相对熵函数,表示对测度ℙ 的惩罚,则
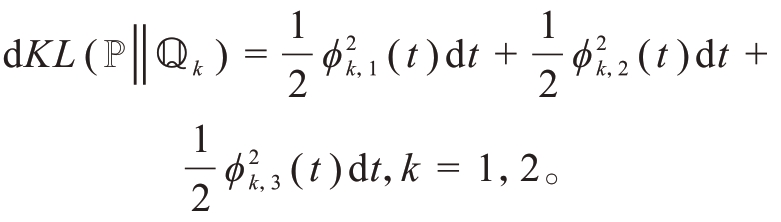
在概率测度ℚk 下,第k 家保险公司的盈余过程式(9)可重新表示为
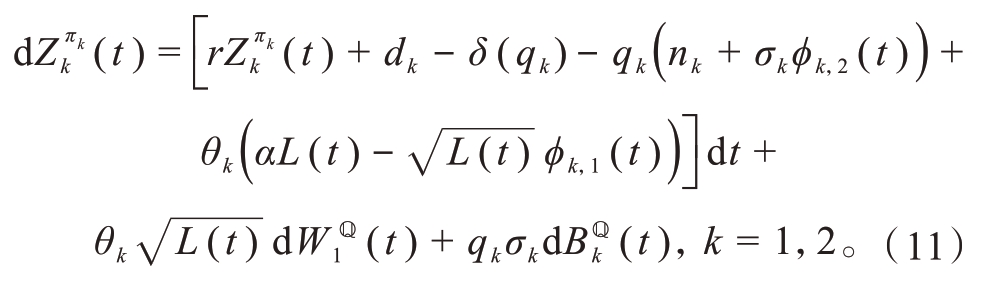
引入模型模糊后,只改变了盈余过程的漂移项,并没有改变方差项。同样地,股票的价格过程可重新表示为
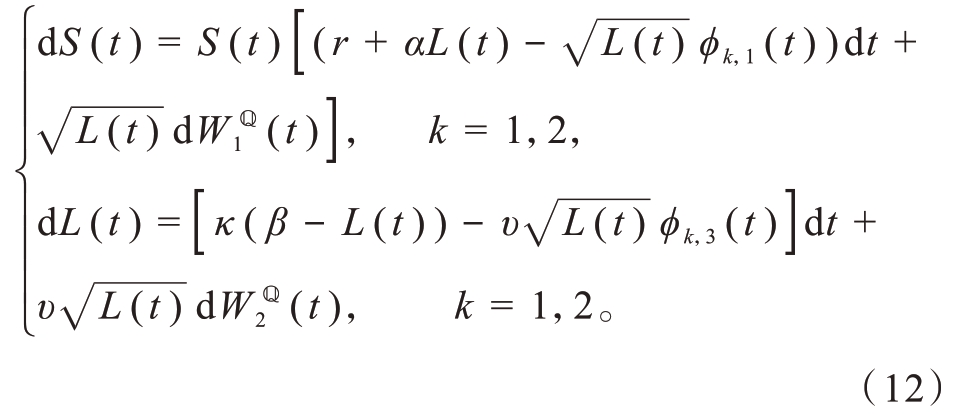
2 家保险公司都选择可允许的再保险和投资策略,以实现自身终端财富的最大化。每一家保险公司都关心自己和对方的终极财富之间的差异,并试图比竞争对手表现得更好。类似于Bensoussan 等[4]、Espinosa 和Touzi[17]的研究,本文将此优化问题表述为2 家竞争保险公司之间的非零和随机微分博弈,即第k 家保险公司的目标是在终端时刻T∈(0,∞) 之前相对绩效 (t):=Zπk k(t)-ωkZmπm(t) 的期望效用最大化,式中:k,m=1,2且k≠m;ωk∈[0,1]为第k 家保险公司对于竞争者绩效的敏感度,ωk 越大,表示越关心自身和对方财富之间的差异。
定义终值财富的条件期望效用为
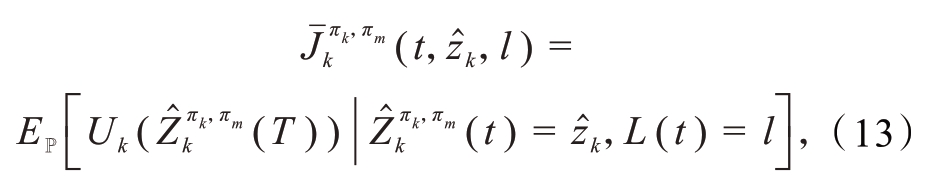
式中: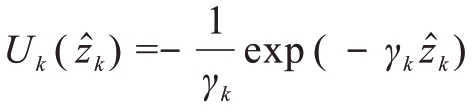 为指数效用函数,满足
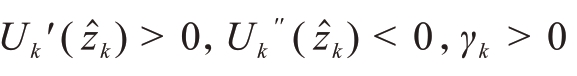 为绝对风险厌恶系数;k,m=1,2且k≠m。
考虑加入模糊厌恶的情况,即保险公司不信任参考测度ℙ 的准确性,而是在Q 中选择了与之等价的概率测度Qk,k=1,2,此时就会有罚金产生。换句话说,保险公司的目标变为在参考测度“最坏”的情况下(即罚金最小),考虑终端时刻T 之前相对绩效的期望效用最大化。
定义终值财富在概率测度Qk 下的条件期望效用,式(13)转换为
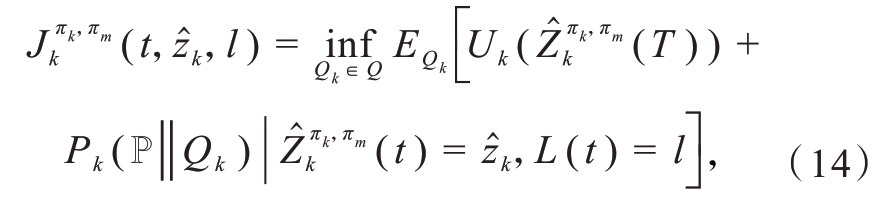
式中:Pk(ℙ‖Qk)是与 (t,
 ,l)同样数量级的罚函数;k,m=1,2且k≠m。
2 家竞争保险公司之间的非零和随机微分博弈问题式(14),即为寻找一对纳什均衡策略(π*1,π*2)∈Π1×Π2。
定义2.1 若对于∀(π1,π2)∈Π1×Π2,下列不等式均满足,则称一对可允许的策略(π*1,π*2)∈Π1×Π2 为纳什均衡策略,即
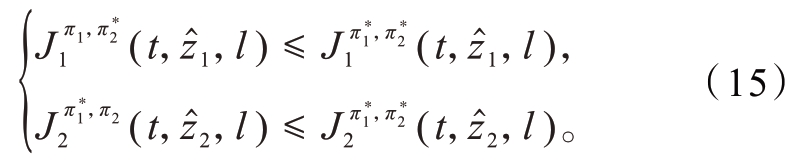
如果式(15)成立,则2 家保险公司的值函数为
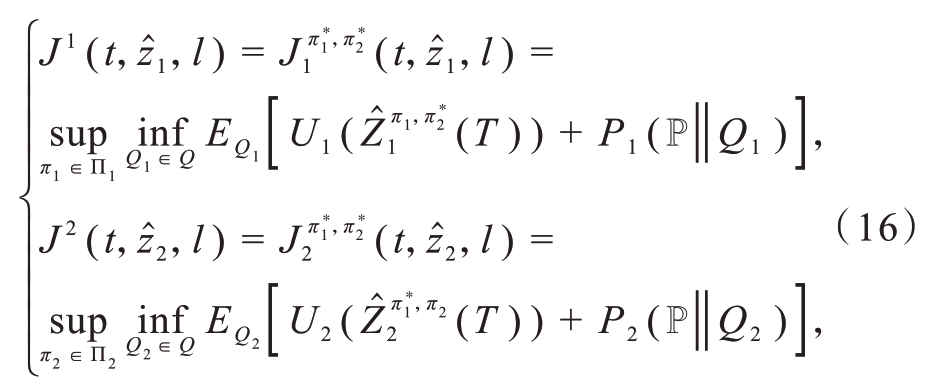
参考Maenhout[18],定义罚函数
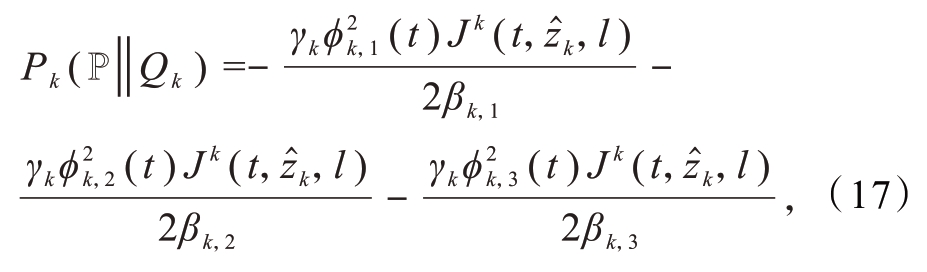
式中:βk,i>0;k=1,2;i=1,2,3,为第k 家保险公司的模糊厌恶系数,描述了其对扩散风险的模糊厌恶程度;当βk,i=0 时,保险公司对这类风险是模糊中性的。相对绩效 (t)在概率测度Qk 下定义为
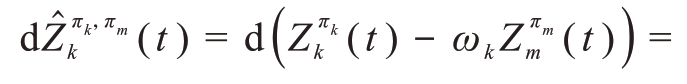
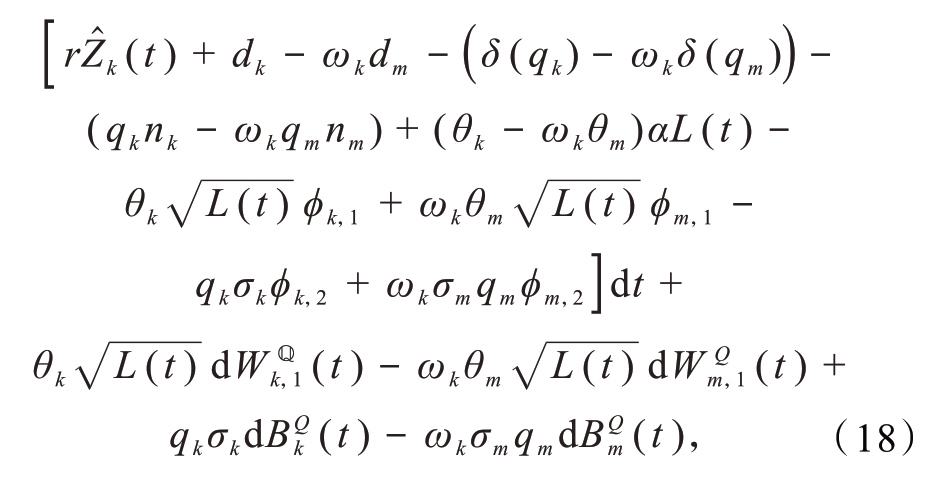
式中:k,m=1,2且k≠m; (0)=
 =xk-ωkxm。
定义算子,其中k,m=1,2且k≠m:
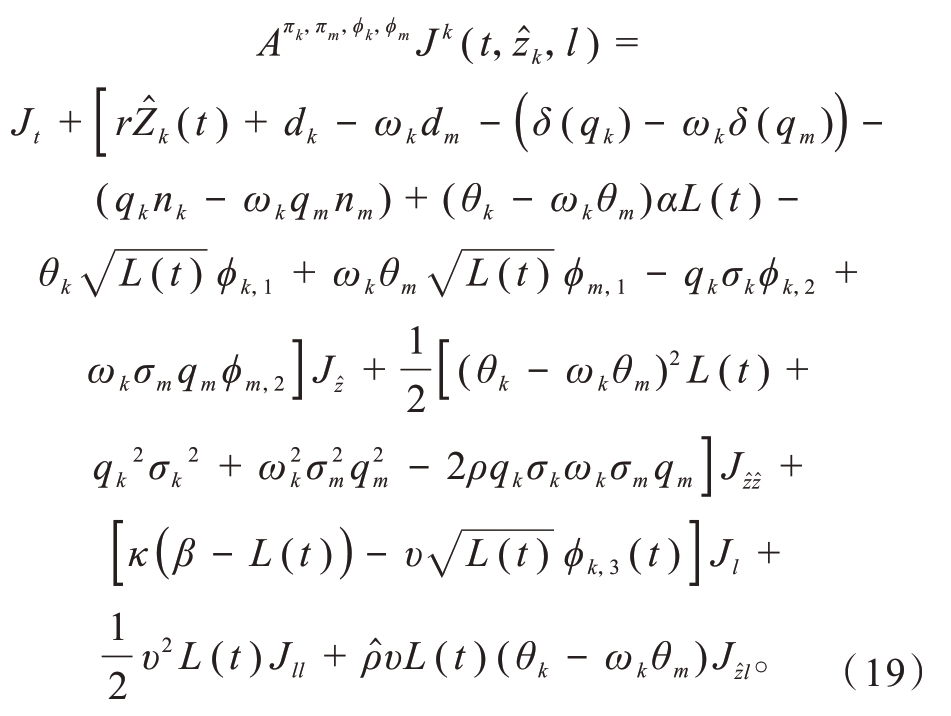
根据动态规划原理[19],如果值函数Jk(t, ,l)∈C1,2,2([0,T]×R×R),k=1,2,且纳什均衡策略解(π*1,π*2)∈Π1×Π2 存在,则2 家保险公司值函数分别满足Hamilton-Jacobi-Bellman(简称为HJB)方程
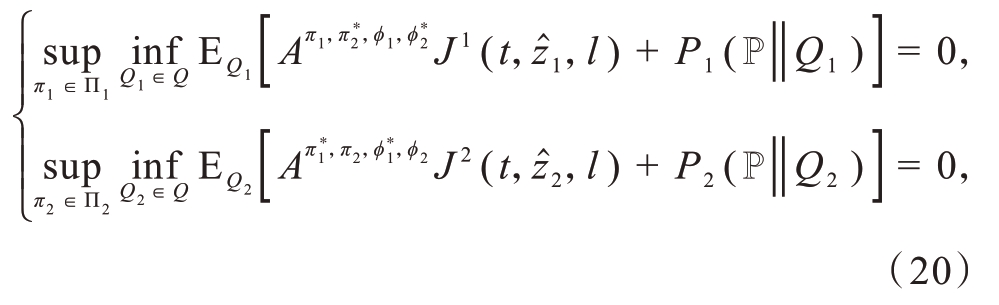
且满足边值条件
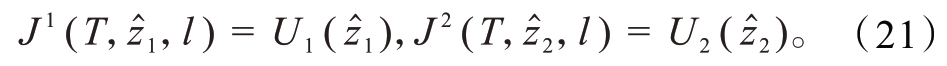
引理3.1.1 Riccati 方程A'k(t)+hk(t)A2k(t)+gk(t)Ak(t)+fk(t)=0,m≠k∈{1,2},
式中:hk(t)=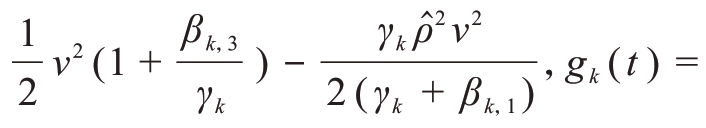
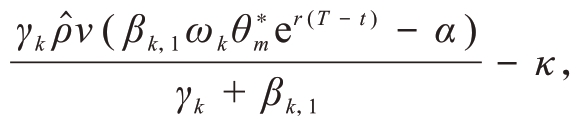
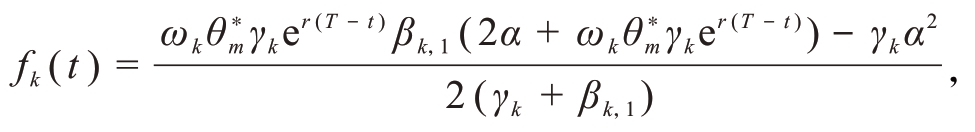
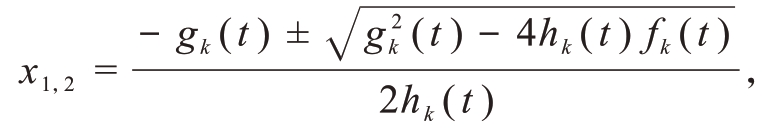
Ak(T)=0,则Ak(t)的解为
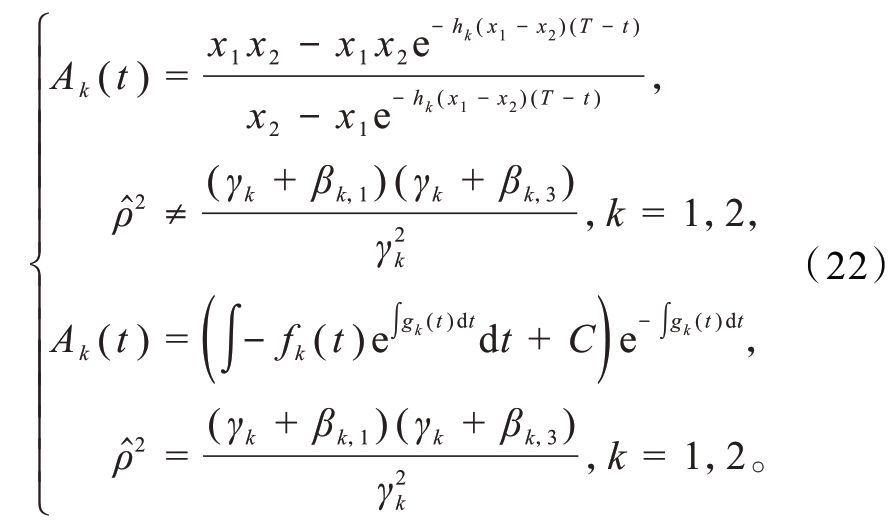
证明 参考Zhao 等[20]的研究,Ak(t)的解可分为2 种情况:
当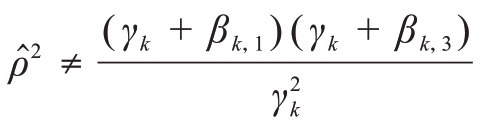 时,首先求解二次方程hk(t)A2(t)+gk(t)A(t)+fk(t)=0,得到解x1,2,原方程可重新表示为
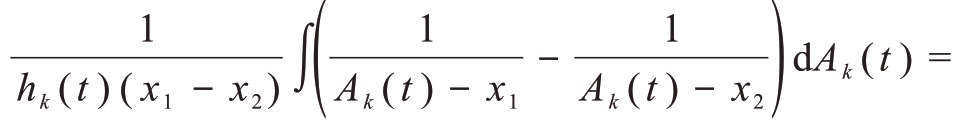 t+C,利用终值条件Ak(T)=0,得到 Ak(t)=
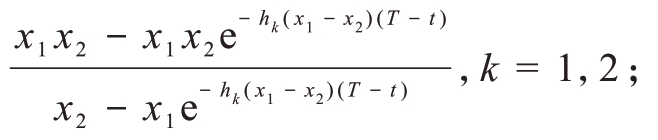
当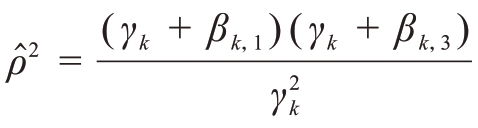 时,即求解常微分方程 A'k(t)+gk(t)Ak(t)+fk(t)=0,利用终值条件Ak(T)=0,得到
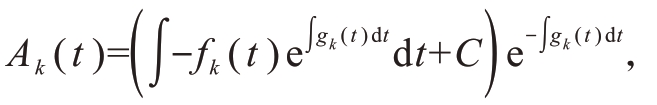 k=1,2。
定理3.1.1 针对非零和随机微分博弈问题(15),对于∀t∈[]0,T,k,m=1,2,k≠m,纳什均衡策略πk*(t)=(q*k(t),θk*(t))∈Πk 如下:
纳什均衡投资策略θ*k(t)为
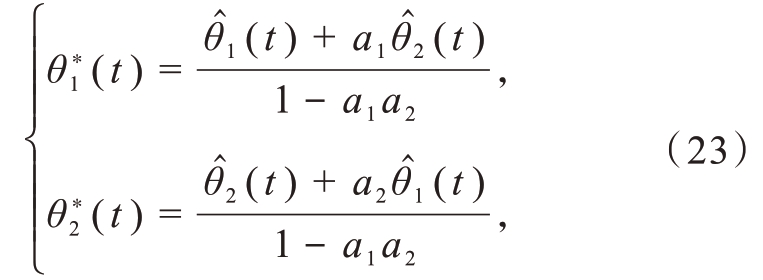
式中: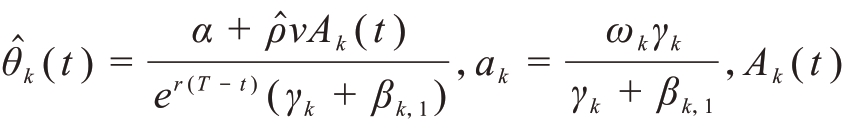 由式(22)给出。
定义 (t),k=1,2,
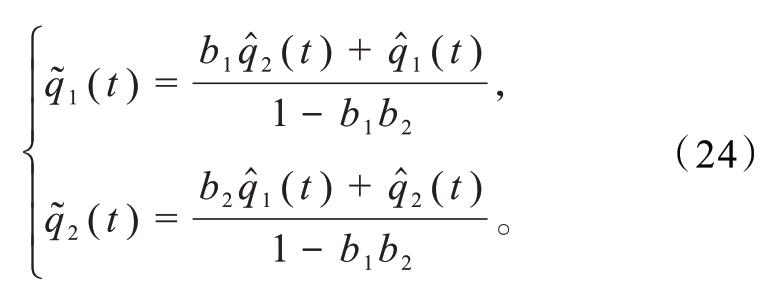
纳什均衡再保险策略q*k(t),k=1,2,有如下4 种情形:
情形1:若 (t)≤ 1,
 (t)≤ 1,则q*1(t)=
 (t),q*2(t)=
 (t);
情形2:若  (t)≤1,
 (t)>1,则 q*1(t)=
 (t),q*2(t)=1;
情形3:若  (t)>1,
 (t)≤1,则 q*1(t)=1,q*2(t)=
 (t);
情形4:若 (t)>1,(t)>1,则 q*1(t)=1,q*2(t)=1。
式中: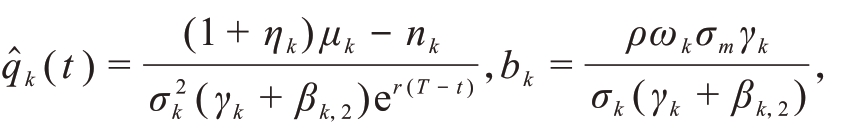 k,m=1,2且k≠m。
证明 首先根据指数效用的函数形式,参考Liang 和Yuen[21]、Chen 和Yang[22]的研究,猜想值函数的形式为
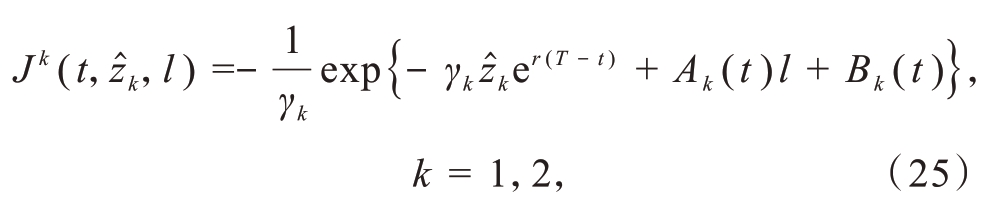
式中:Ak(t),Bk(t)满足边界条件Ak(T)=Bk(T)=0,根据式(25)求微分得到
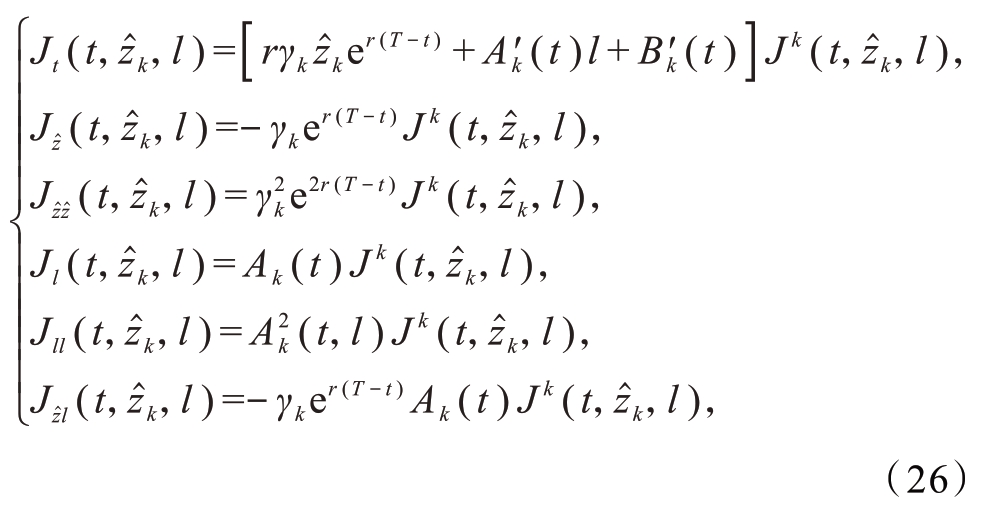
将式(17)、(19)和(26)代入式(20)可得
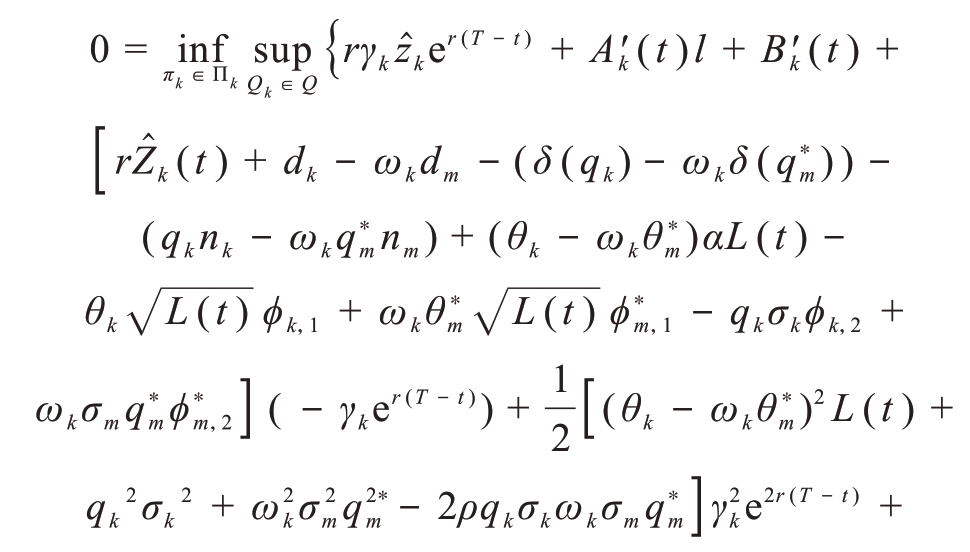
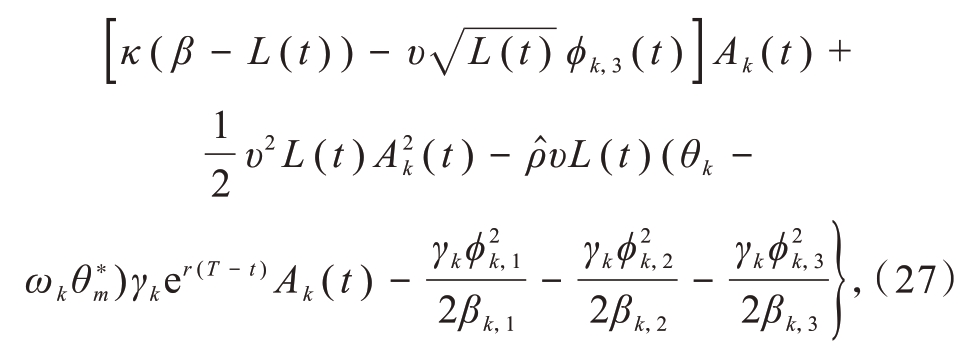
式中k,m=1,2且k≠m。根据一阶条件可以得到
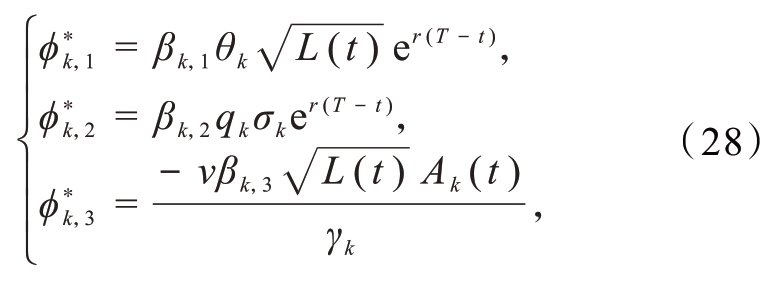
将式(5)和(28)代入式(27)可得
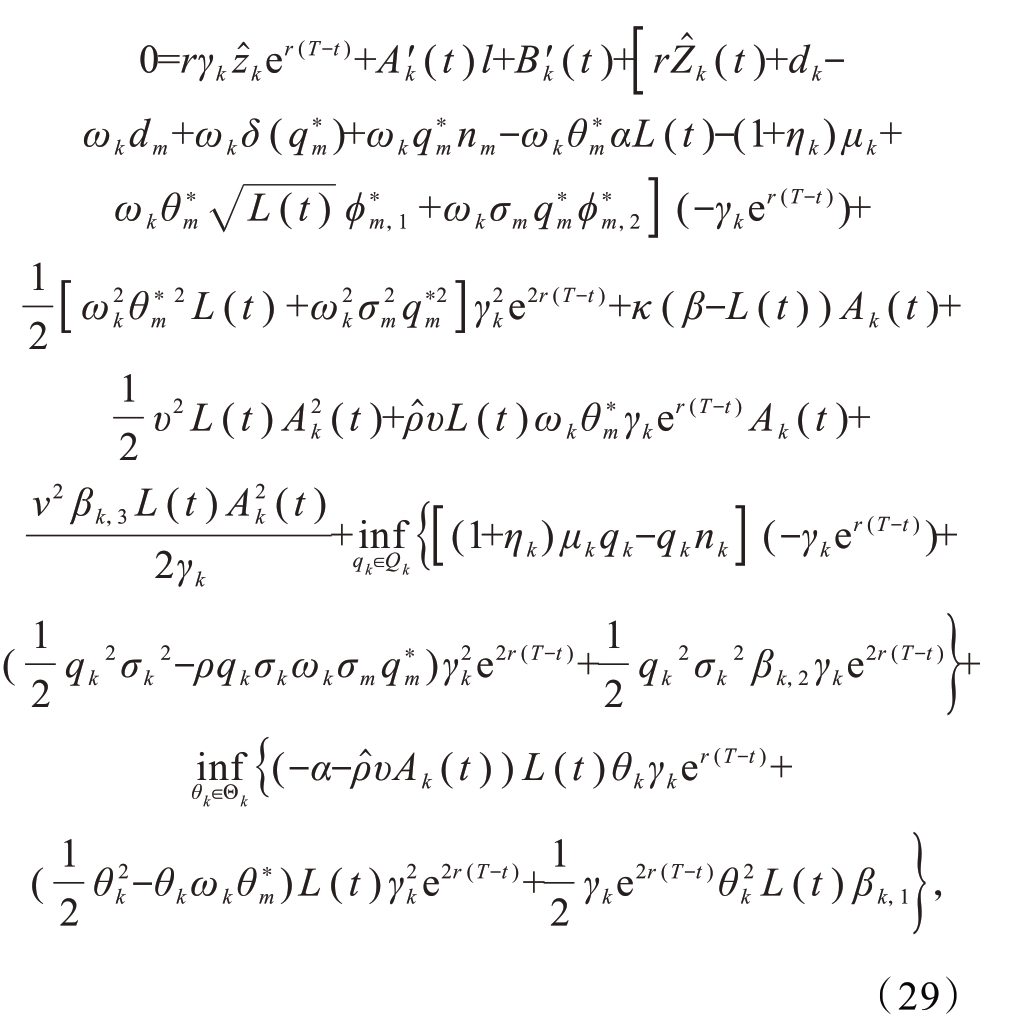
根据一阶条件,得到纳什均衡投资策略θk*(t),k=1,2 为下面耦合系统的解:
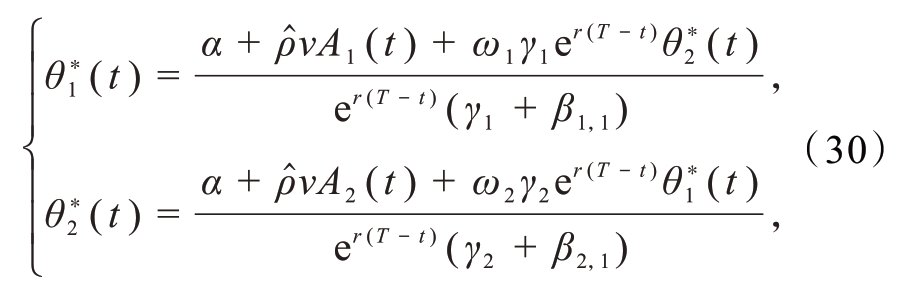
经整理可得
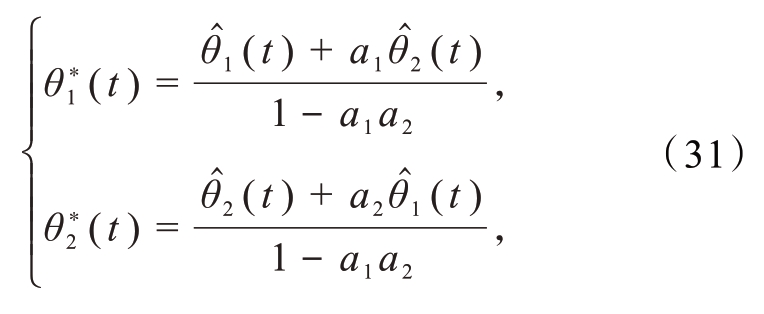
式中: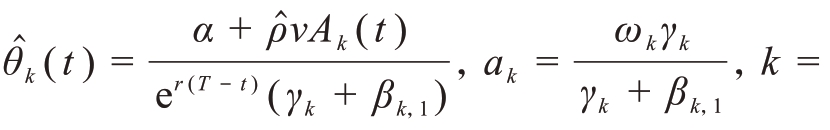 1,2。
根据一阶条件,得到再保险策略 (t),k=1,2为下面耦合系统的解,即
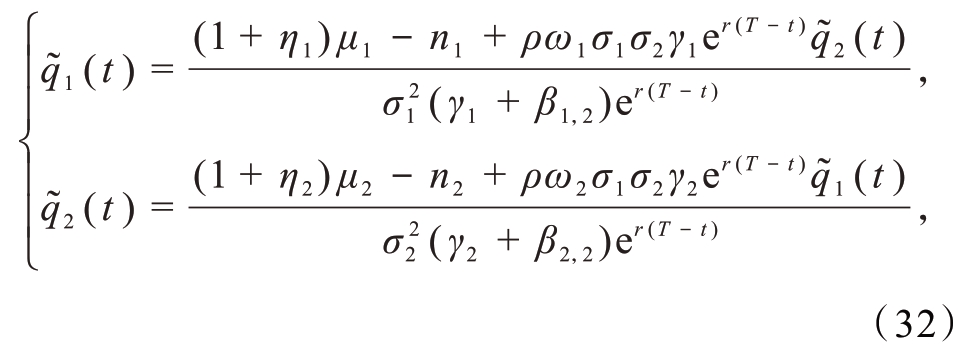
经整理可得
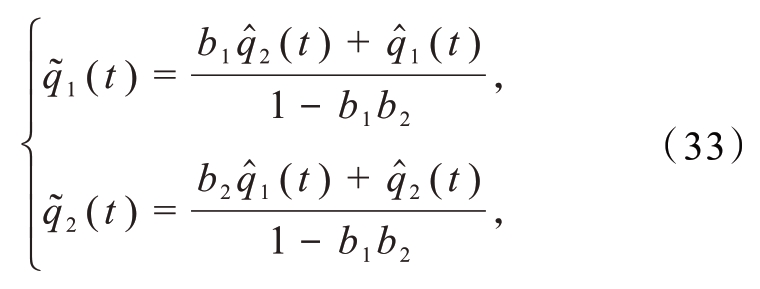
式中: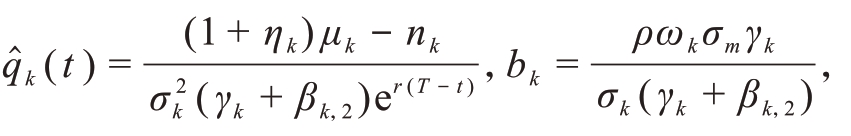 k,m=1,2且k≠m。
纳什均衡再保险策略q*k(t)与 (t)很接近,但由于1≥ρ,ωk≥0、γk≥0、βk,2≥0,则有1-b1b2=1-
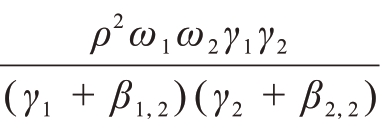 ≥0,因此
 (t)≥0,又由于纳什均衡再保险策略q*k(t)∈[0,1],故需要分情形讨论,如定理3.1.1。
将得到的纳什均衡策略πk*(t)=(q*k(t),θk*(t))代入式(29),整理得到
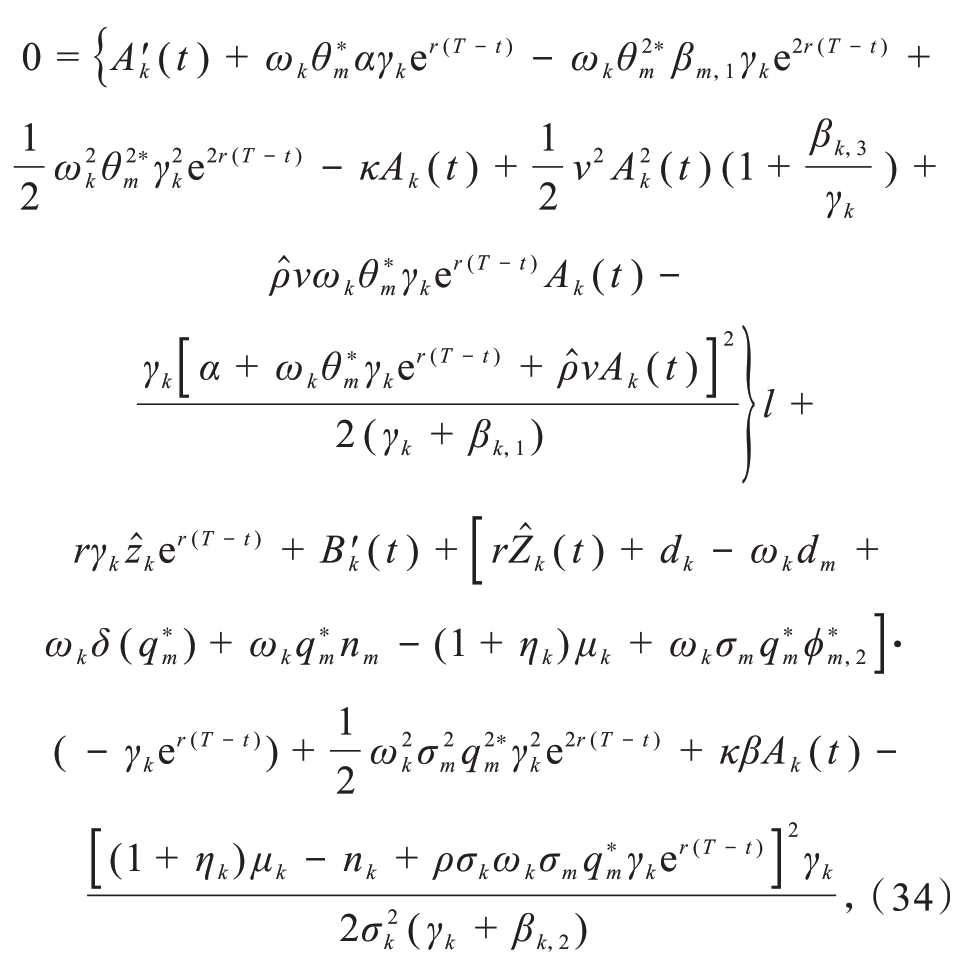
又此方程对所有l 均成立,故l 的系数为零,整理得到
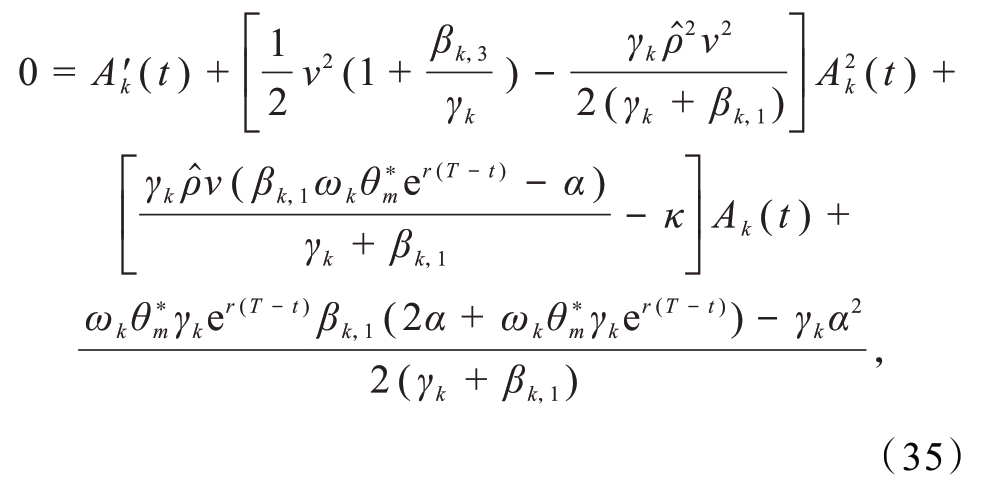
可以注意到,上述方程为关于Ak(t)的Riccati 方程,根据引理1 可得到式(22)。
定理3.1.2(验证定理) 如果存在一个函数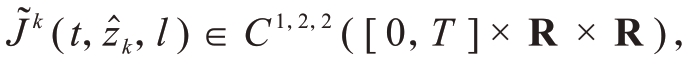 一个控制策略(πk*,φ*k)∈Πk×Φ,k,m=1,2且k≠m,满足:
(1)对于任意φk∈Φ,都有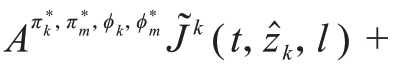
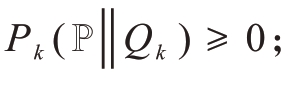
(2)对于任意πk∈Πk,都有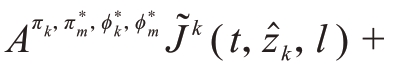
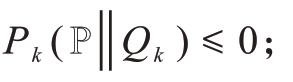
(3)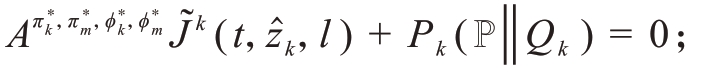
(4)对于所有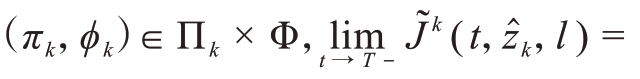
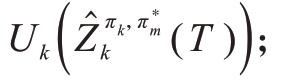
(5)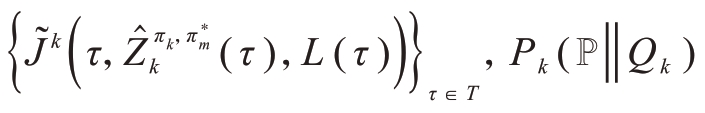 是一致可积的,其中T≜{τ|τ≤T}。
则π*k∈Πk 是最优策略,且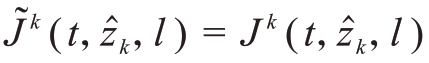 是对应的值函数。
证明 证明过程可参考Mataramvura 和Øksendal[23]的研究,此处省略。
定理3.2.1 若第k 家保险公司对概率测度ℙ 持模糊中性态度,则不存在替代测度Qk∈Q,即φk,i(t)=0,βk,i=0,i=1,2,3,k=1,2。此时,对于∀t∈[0,T],k=1,2,纳什均衡策略π*k(t)=(q*k(t),θk*(t))∈Πk 如下:
纳什均衡投资策略 (t)为
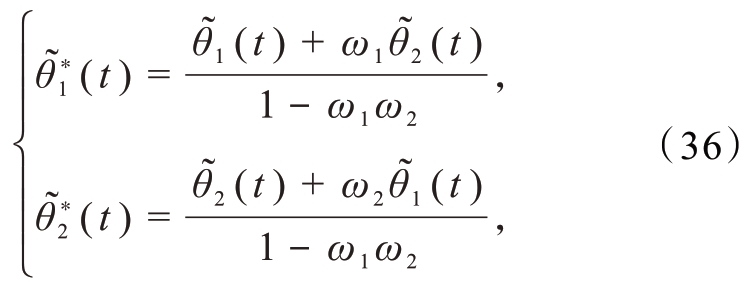
其中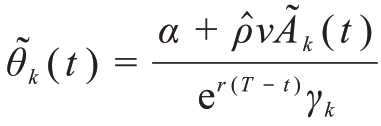 ,且
 (t)的解为
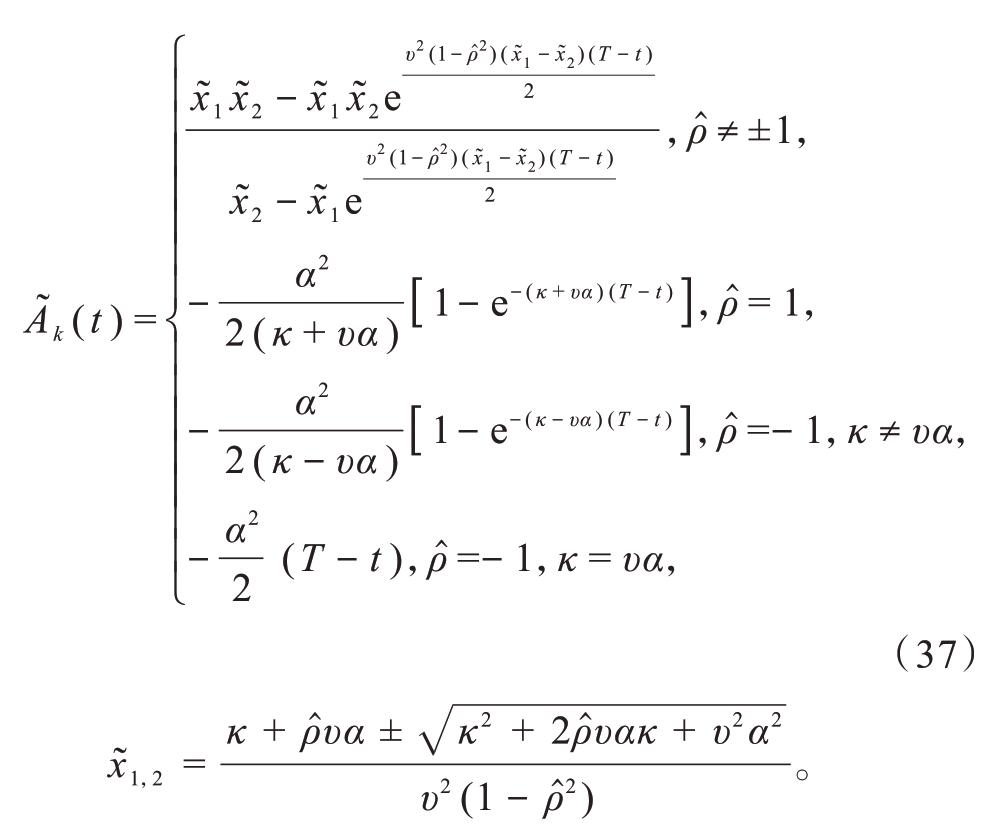
纳什均衡再保险策略 (t),有4 种情形。
情形1:若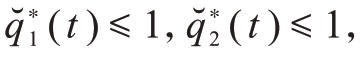 则
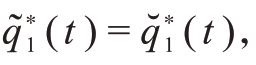
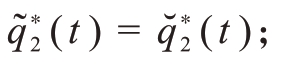
情形2:若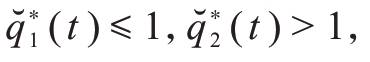 则
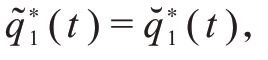
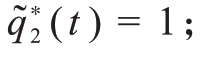
情形3:若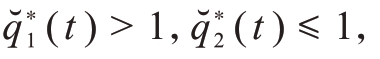 则
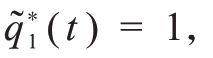
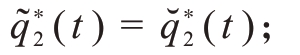
情形4:若 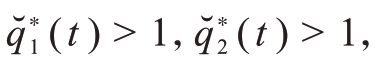 则
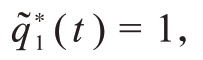
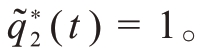
式中: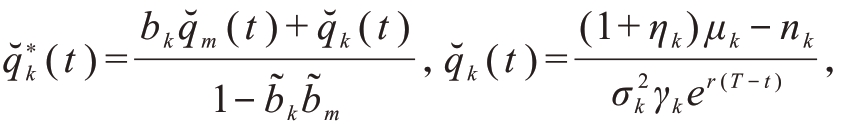
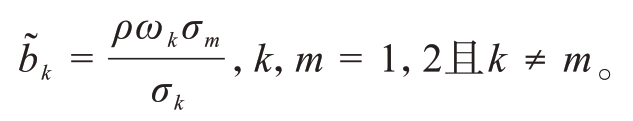
注1 对于保险公司持模糊中性态度时得出的纳什均衡策略与Deng 等[13]中定理4.1 结果相一致。证明过程与本文定理3.1.1 类似,在此省略。
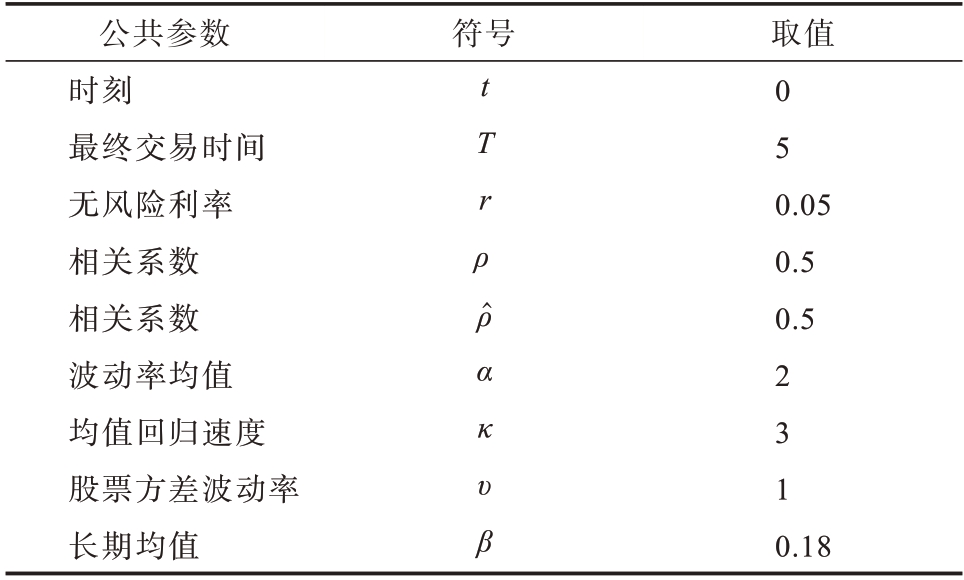
为了分析模型参数对纳什均衡再保险投资策略的影响,进行如下的数值模拟,其中参数取值参考Wang 等[11]和Deng 等[13]的研究,具体如表1和表2所示。
表1 公共参数的取值
公共参数时刻最终交易时间无风险利率相关系数相关系数波动率均值均值回归速度股票方差波动率长期均值符号取值t T r ρ ρα κ υ β 0 5 0.05 0.5 0.5 2 3 1 0.18
表2 不同保险公司参数取值

名称第一家保险公司第二家保险公司μ nσ η ω γ β1 β2 β3 0.9 1.0 0.375 0.200 2.0 1.5 0.15 0.20 0.2 0.4 0.30 0.25 0.2 0.5 0.4 0.6 0.6 0.7
情形1 中γ 对q*k(t)的影响如图1所示。纳什均衡再保险策略q*k(t)会随着时间的增加而增大,这表示保险公司在经营过程中随着财富的累积,自身抵抗风险的能力会不断加强,从而再保险自留额增大。此外当风险厌恶系数γk 增大时,纳什均衡再保险策略q*k(t)变小,这是由于对风险的厌恶程度降低,所以保险公司倾向于承担更多的自留水平,以减少再保费的支出。
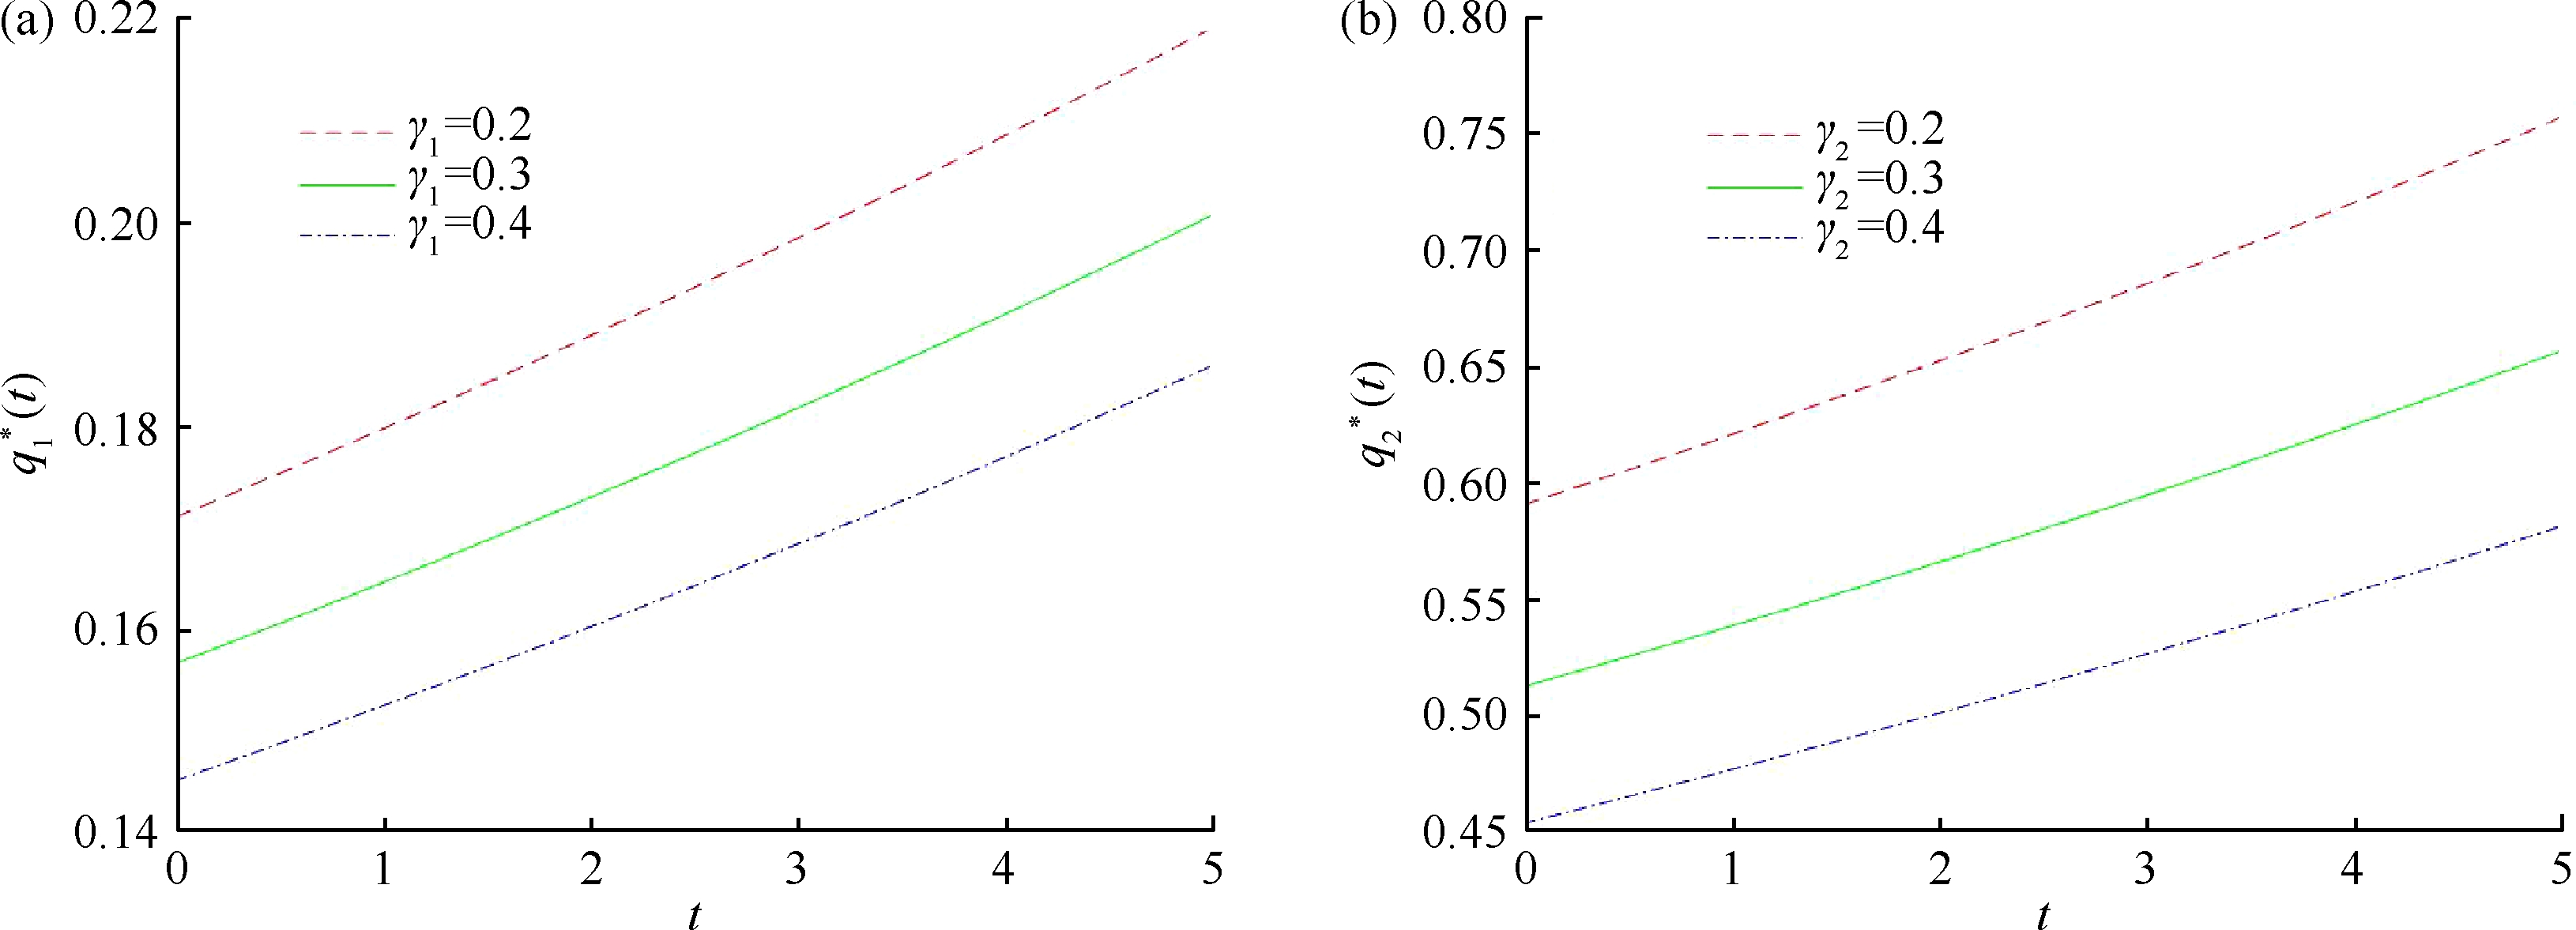
图1 情形一中γ 对q*(t)的影响(a)γ1 对q*1(t);(b)γ2 对q*2(t)
ω1、ω2 对不同保险公司最优再保险策略的影响如图2和3 所示。在2 种情形下,2 家保险公司的自留额比例q*k(0),(0)都随绩效敏感程度ωk 的增加而增加。一个合理的解释是,ωk 越大,表明保险公司更关心其相对的终端财富,因此倾向于保留更多的风险以支付更少的再保险保费。同样,当竞争对手的绩效敏感度越高时,意味着市场竞争越大,保险公司也会采取更激进的策略,即增加自留额水平。当保险公司持模糊厌恶态度时,q*k(0)<1,范围比 (0)小,说明2 家保险公司在博弈中的模糊性厌恶态度使其对风险更加保守,因此他们倾向于将更多的风险转移给再保险公司。同时,当保险公司持模糊中性态度时,
 (0)>1,表明此时保险公司不仅不购买再保险,且还要作为再保险人,承担更多的索赔风险,以赚取更多的再保费。
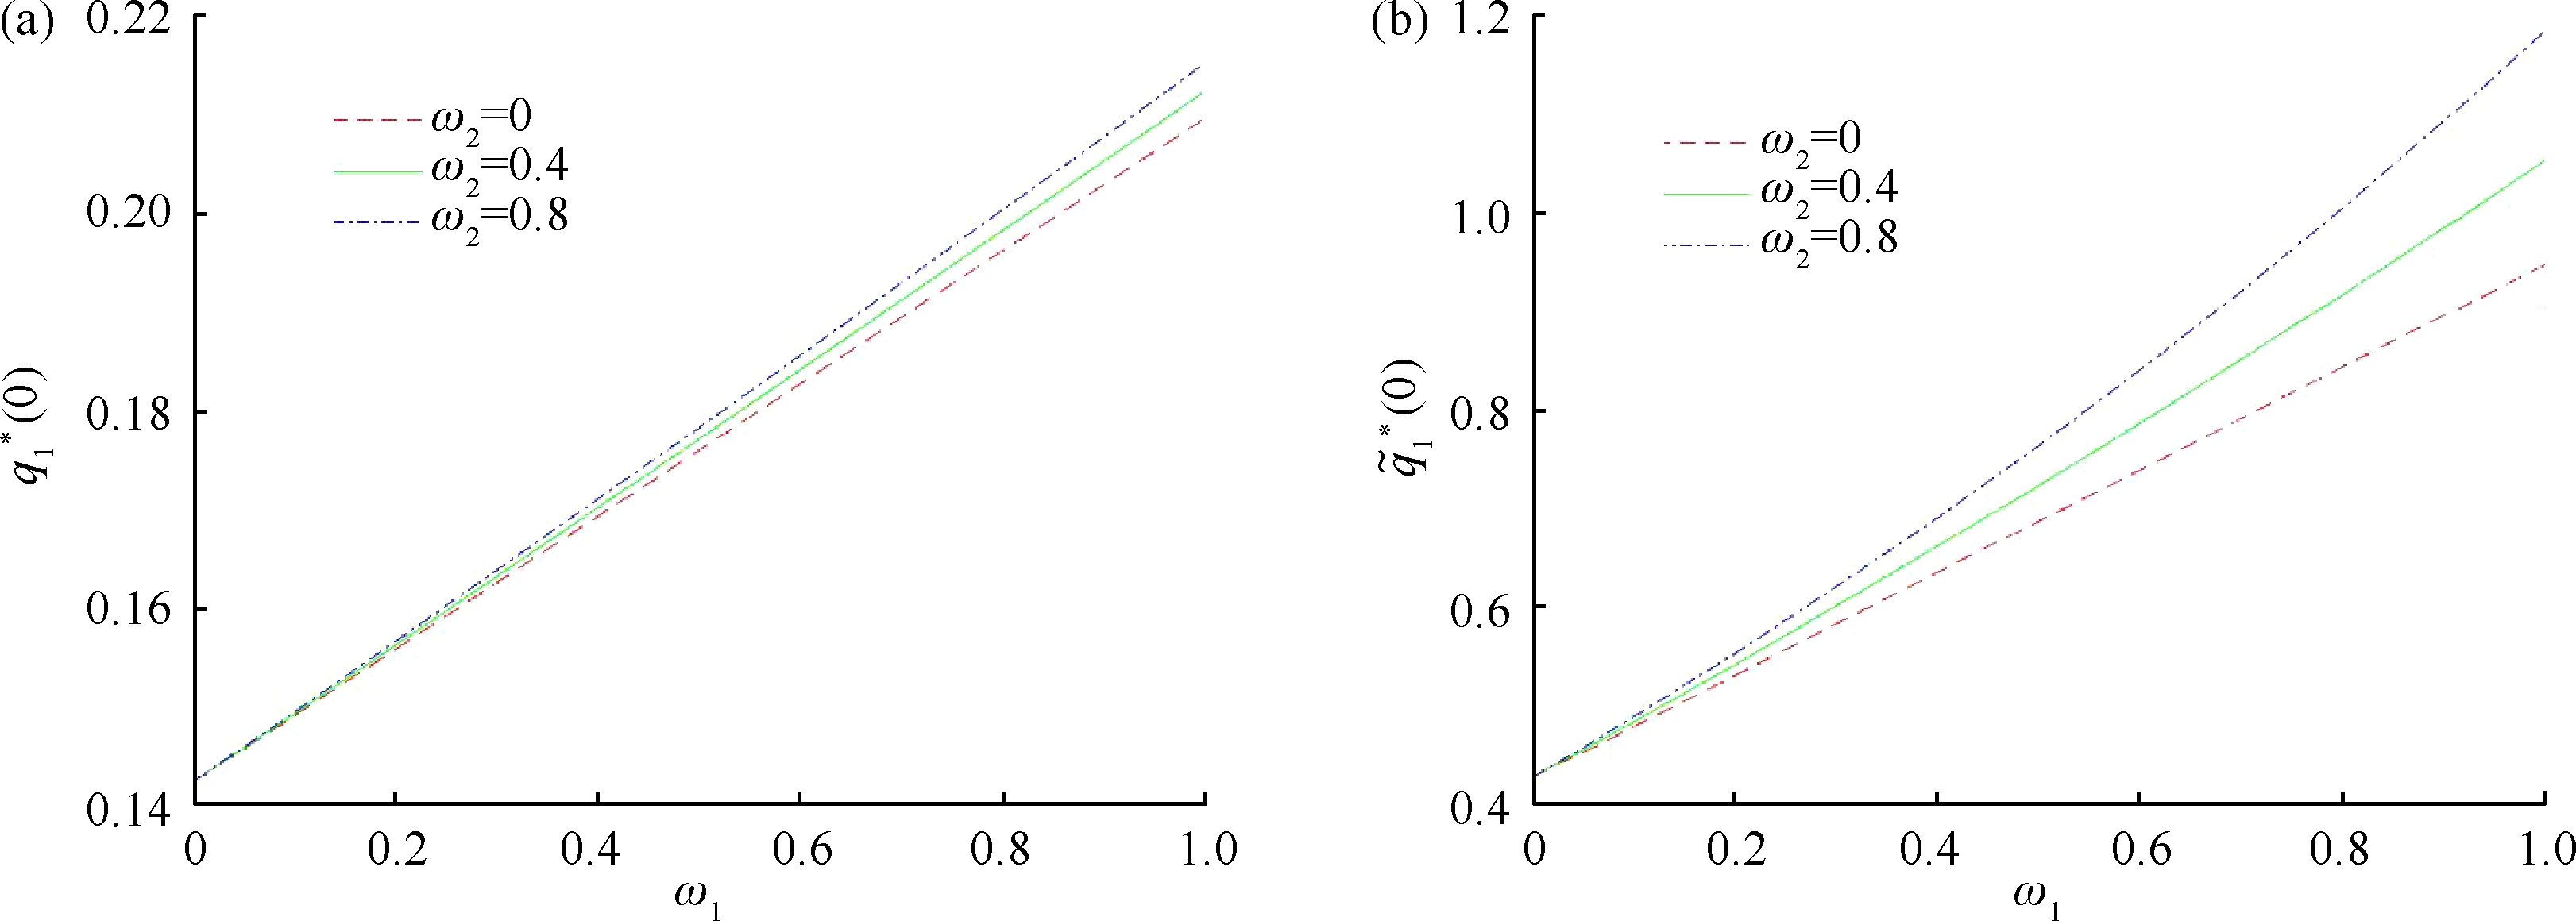
图2 ω1、ω2 对第一家保险公司最优再保险策略的影响(a)情形1 中ω1、ω2 对q*1(0);(b)情形2 中ω1、ω2 对 (0)
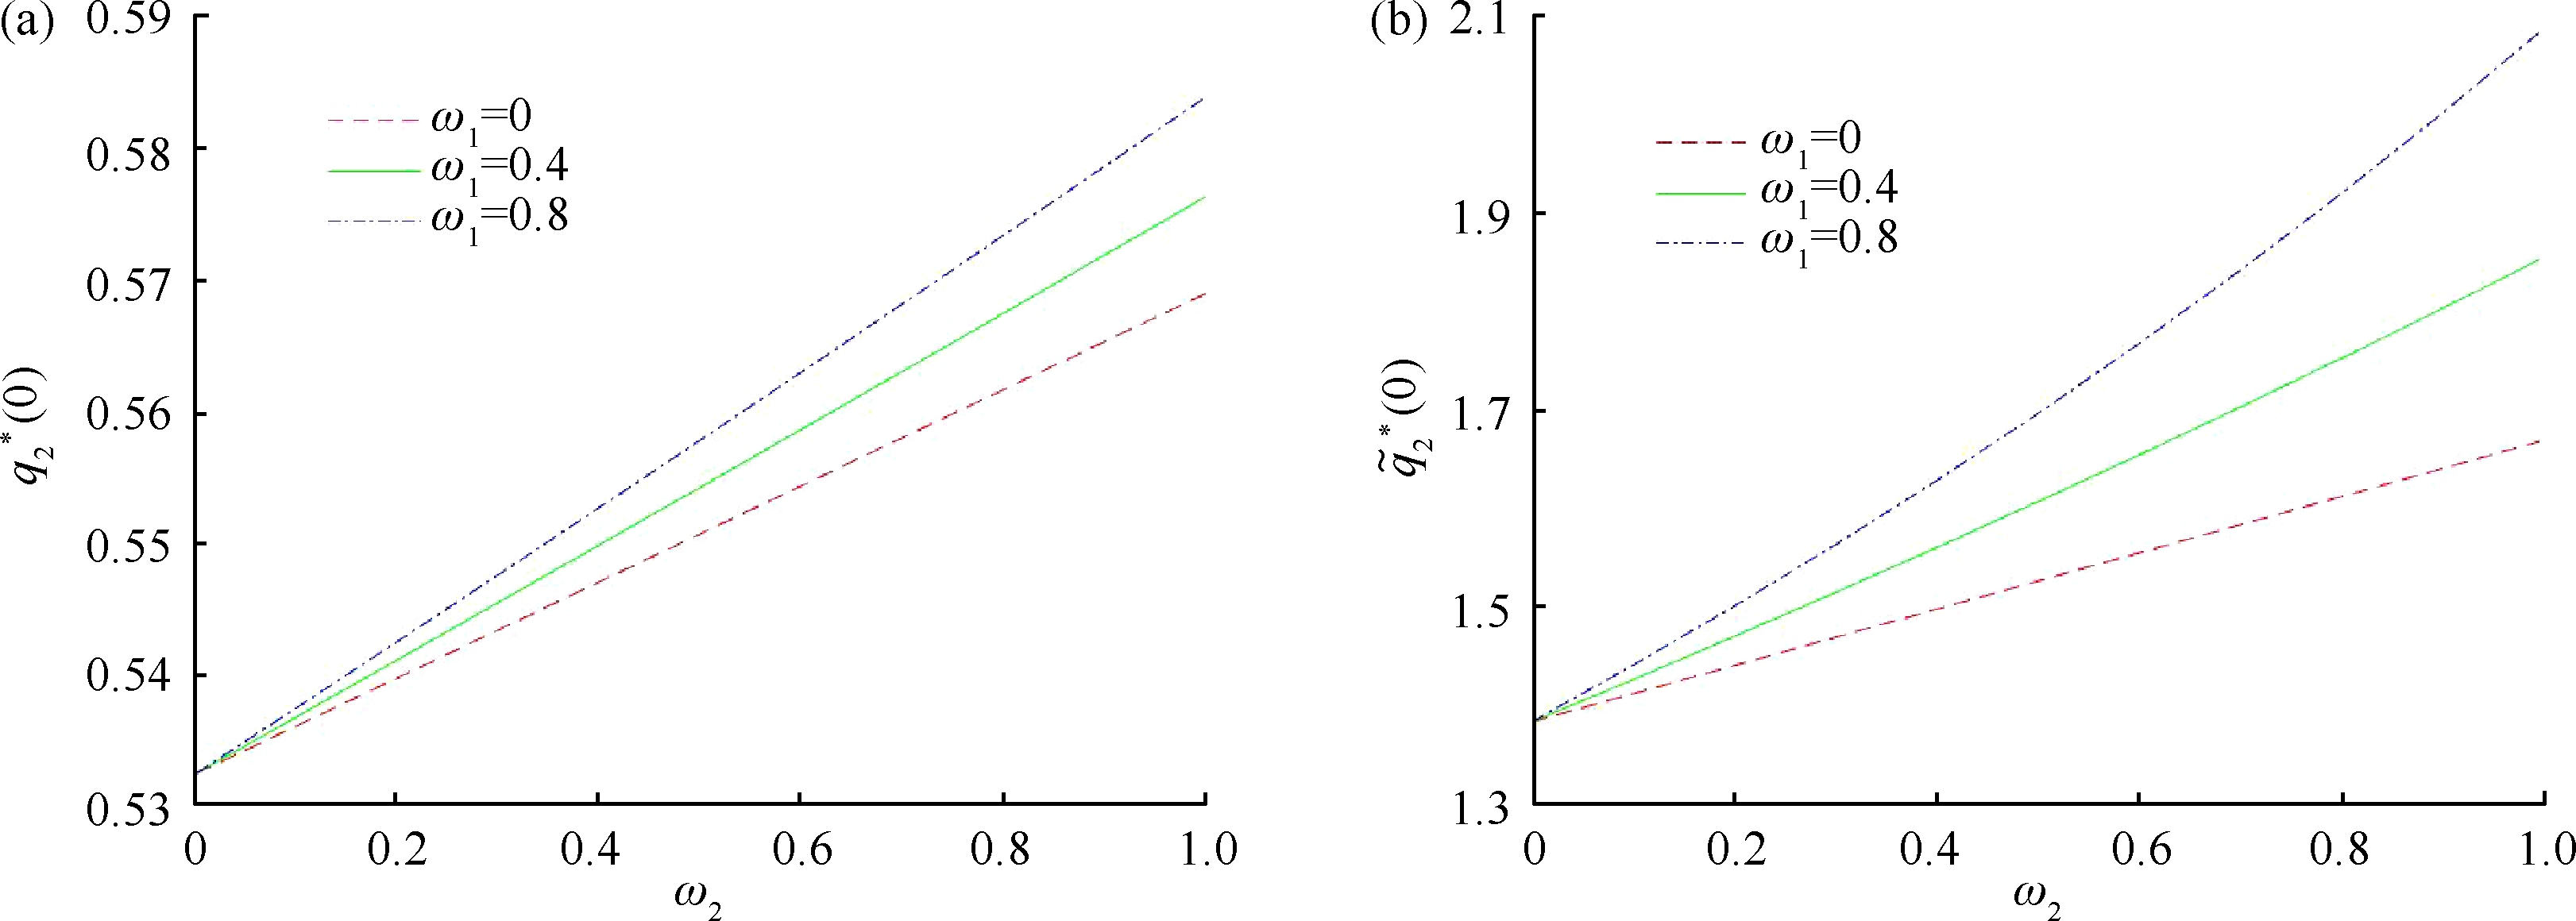
图3 ω1、ω2 对第二家保险公司最优再保险策略的影响(a)情形1 中ω1、ω2 对q*2(0);(b)情形2 中ω1、ω2 对 (0)
情形2 中γ 对 (t)的影响如图4所示。当股票市场和股票波动率之间的相关系数
 >0 时,纳什均衡投资策略
 (t)随着时间的增加而增大,这是由于随着财富的累积,保险公司会加大对风险资产的投资以获取更高收益。当
 <0 时,
 (t)会随着时间的增加而先增大后减少,是因为风险资产的收益率和波动率成负相关,因此投资额增加到一定程度后会开始减少。随着风险厌恶系数γk 的增大,保险公司也会减少对风险资产的投资。
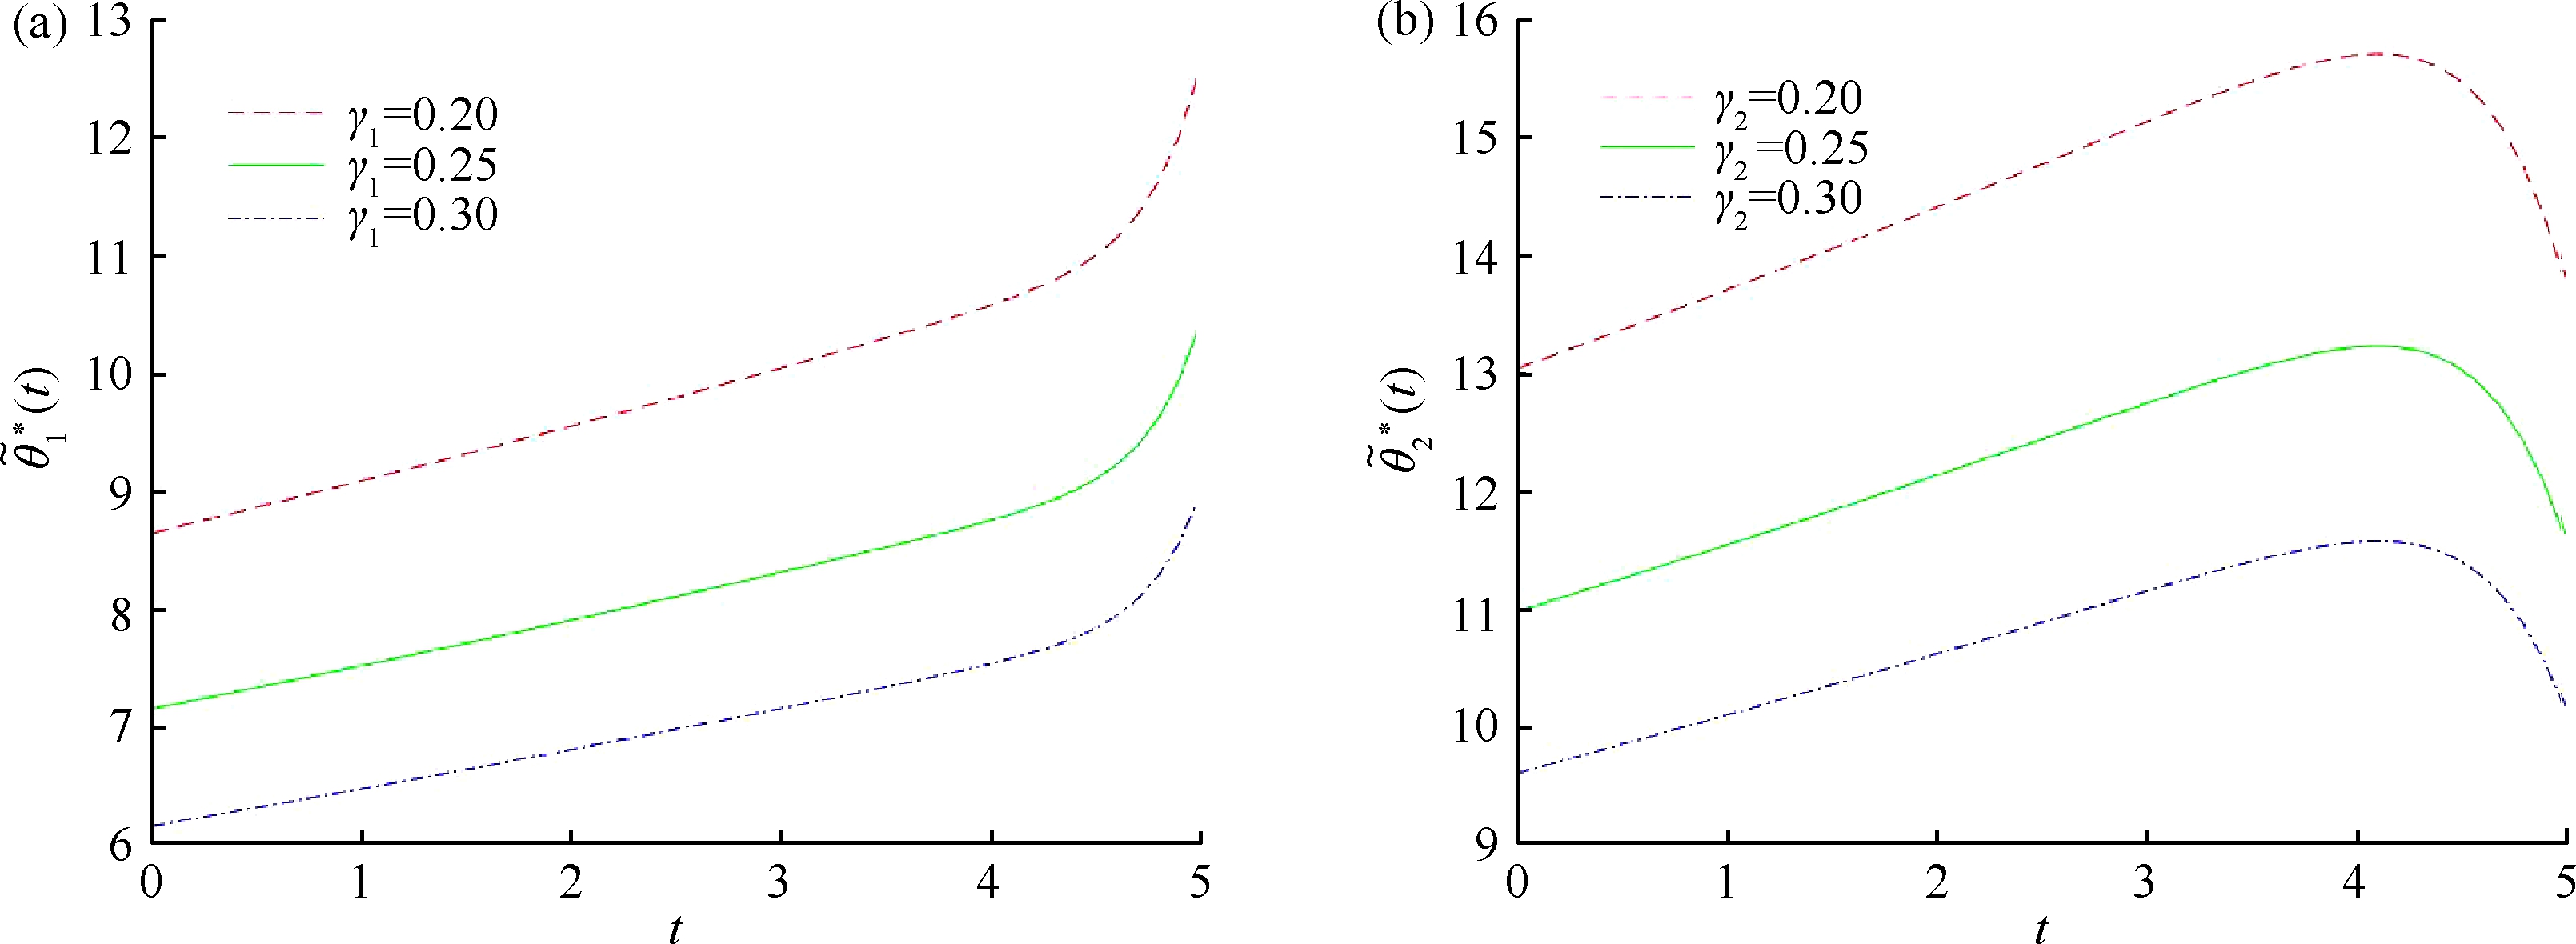
图4 情形2 中γ 对 (t)的影响(a)γ1 对
 (t);(b)γ2 对
 (t)
情形2 中ω1、ω2 对最优投资策略的影响如图5所示。随着绩效敏感程度的增加,2 家保险公司在股票上的投资额都随之增加。对每家保险公司来说,最优的策略是投入更多的投资额以便在终端时刻前打败竞争者。
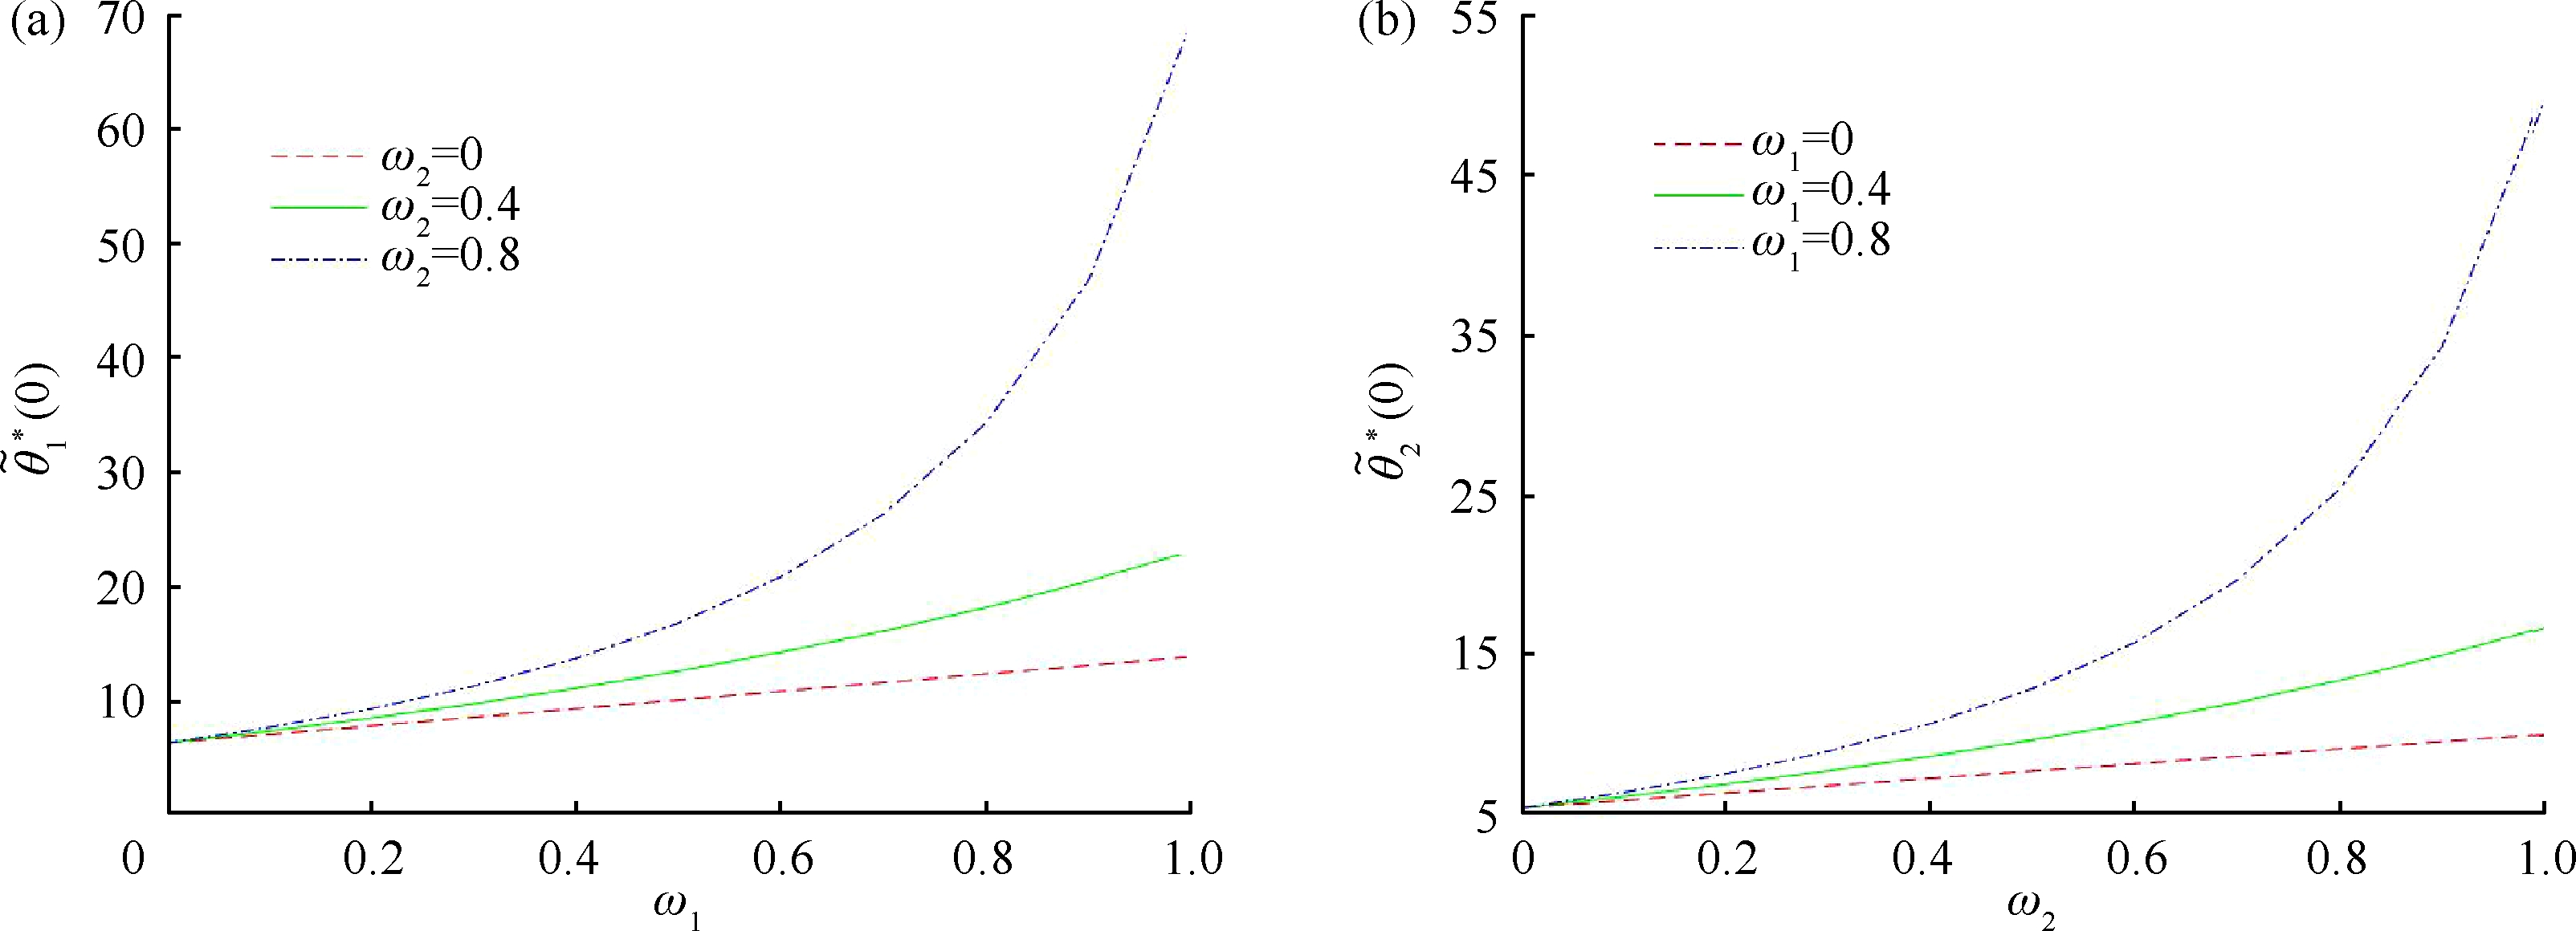
图5 情形2 中ω1、ω2 对最优投资策略的影响(a)ω1、ω2 对 (0);(b)ω1、ω2 对
 (0)
情形2 中 、κ 对
 (0)的影响如图6所示。展示了股票市场和股票波动率之间的相关系数
 ,以及Heston模型中均值回归速度κ对最优投资策略的影响。当
 >0 时,即股票收益和股票波动率呈正相关,均值回归速度κ 越大,意味着股票波动率L(t)会更快地回到均值附近,此时会带来更稳定的股票收益,股票投资额随之加大;而<0时恰好相反,随着κ增大,股票投资额逐渐减少;当
 =0时,股票收益与股票波动率毫无关系,因此随着κ增大,股票投资额呈一条水平直线。
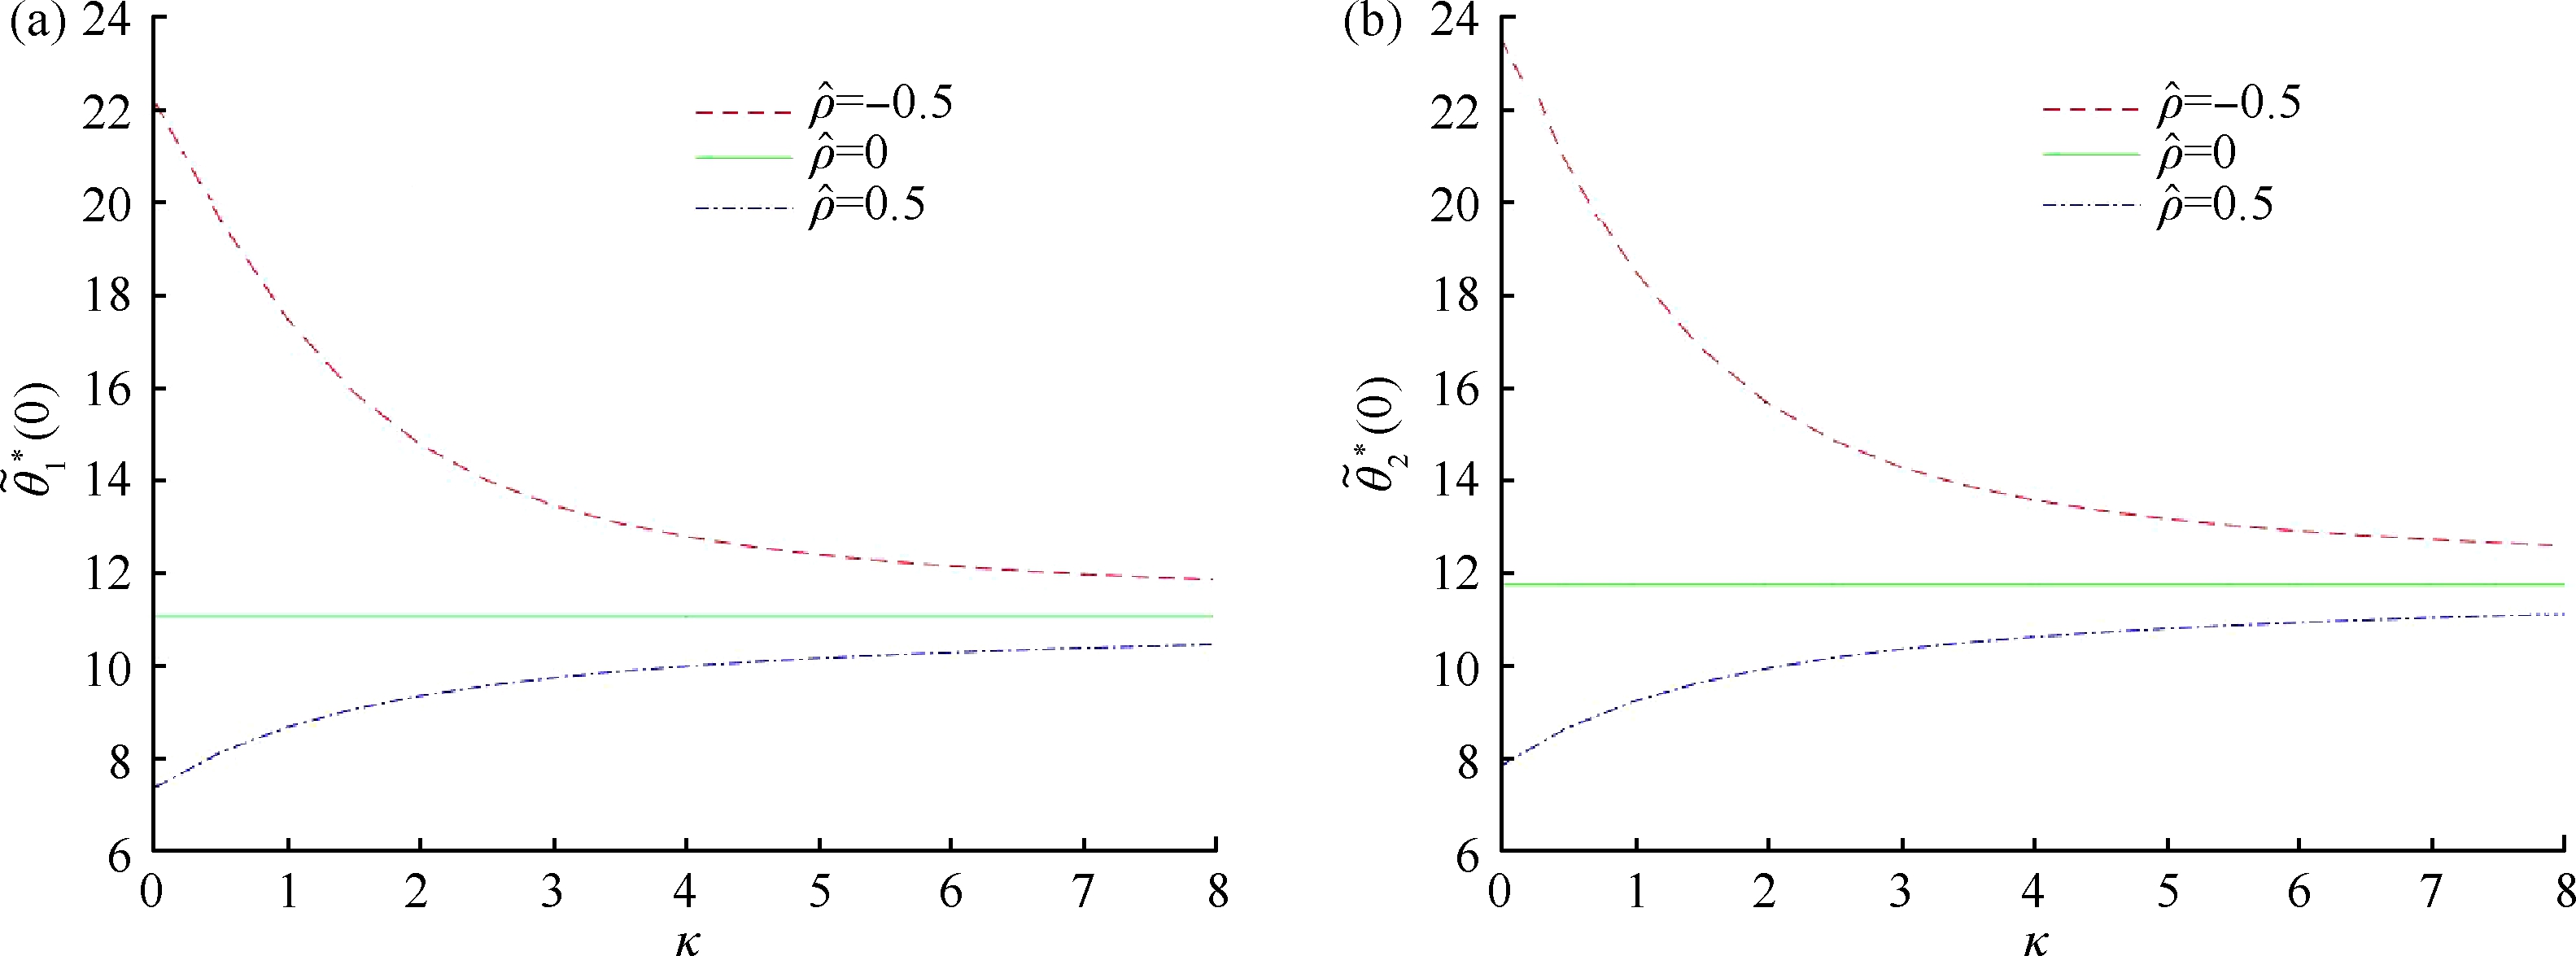
图6 情形2 中 、κ 对
 (0)的影响(a)
 、κ 对
 (0);(b)
 、κ 对
 (0)
本文主要研究了Heston 投资模型下2 家竞争保险公司之间的非零和博弈问题,假设每家保险公司都以终端时刻前相对绩效的期望效用最大化为目标,分别在其持模糊厌恶态度和模糊中性态度下,推导出值函数满足的HJB 方程并得到了纳什均衡再保险和投资策略。通过数值算例显示,当保险公司开始关注竞争对手的表现时,其会增加再保险的自留额,并且加大对金融市场的投资,即竞争会使保险公司的策略变得更激进。论文结果区别于Wang 等[11]和Deng 等[13]的研究,在模糊厌恶态度下,保险公司会变得更谨慎,也就是说在相互竞争的情况下,保险公司倾向于将更多的风险转移给再保险公司和对金融市场更少的投资。同时Heston模型中的均值回归速度也会影响对风险资产的投资额。
[1]SID B.Stochastic differential portfolio games[J].Journal of Applied Probability,2000,37(1):126-147.
[2]罗琰,杨招军.基于随机微分博弈的保险公司最优决策模型[J].保险研究,2010(8):48-52.
[3]TAKSAR M,ZENG X.Optimal non-proportional reinsurance control and stochastic differential games[J].Insurance(Mathematics and Economics),2011,48(1):64-71.
[4]BENSOUSSAN A,SIU C C,YAM S C P,et al.A class of non-zero-sum stochastic differential investment and reinsurance games[J].Automatica,2014,50(8):2025-2037.
[5]ZHANG N,JIN Z,QIAN L,et al.Stochastic differential reinsurance games with capital injections[J].Insurance(Mathematics and Economics),2019,88:7-18.
[6]MENG H,LI S,JIN Z.A reinsurance game between two insurance companies with nonlinear risk processes[J].Insurance(Mathematics and Economics),2015,62:91-97.
[7]CAMPI L,SANTIS D D.Nonzero-sum stochastic differential games between an impulse controller and a stopper [J].Journal of Optimization Theory and Applications,2020,186(2):688-724.
[8]CAIRNS A J G.A discussion of parameter and model uncertainty in insurance[J].Insurance(Mathematics and Economics),2000,27(3):313-330.
[9]刘兵,周明.模糊厌恶下的最优投资与最优保费策略[J].系统工程理论与实践,2020,40(7):1707-1720.
[10]PUN C S,WONG H Y.Robust non-zero-sum stochastic differential reinsurance game[J].Insurance(Mathematics and Economics),2016,68:169-177.
[11]WANG N,ZHANG N,JIN Z,et al.Robust non-zerosum investment and reinsurance game with default risk[J].Insurance(Mathematics and Economics),2019,84:115-132.
[12]杨璐,朱怀念,张成科.Heston 模型下基于期权投资的鲁棒最优控制[J].系统工程学报,2021,36(2):157-170.
[13]DENG C,ZENG X,ZHU H.Non-zero-sum stochastic differential reinsurance and investment games with default risk [J].European Journal of Operational Research,2018,264(3):1144-1158.
[14]SCHMIDLI H.Stochastic control in insurance[M].London:Springer-Verlag,2008.
[15]COX J C,INGERSOLL J E,ROSS S A.A theory of the term structure of interest rates[J].Econometrica,1985,53(2):385-408.
[16]KLEBANER F C.Introduction to stochastic calculus with applications[M].London:Imperial College Press,2008.
[17]ESPINOSA G E,TOUZI N.Optimal investment under relative performance concerns [J].Mathematical Finance,2015,25(2):221-257.
[18]MAENHOUT P J.Robust portfolio rules and asset pricing[J].Review of Financial Studies,2004,17(4):951-983.
[19]FLEMING W H,SONER H M.Controlled markov processes and viscosity solutions[M].New York:Springer,2006.
[20]ZHAO H,RONG X,ZHAO Y.Optimal excess-of-loss reinsurance and investment problem for an insurer with jump-diffusion risk process under the Heston model[J].Insurance(Mathematics and Economics),2013,53(3):504-514.
[21]LIANG Z,YUEN K C.Optimal dynamic reinsurance with dependent risks:variance premium principle[J].Scandinavian Actuarial Journal,2016(1):18-36.
[22]CHEN Z P,YANG P.Robust optimal reinsuranceinvestment strategy with price jumps and correlated claims[J].Insurance(Mathematics and Economics),2020,92:27-46.
[23]MATARAMVURA S,ØKSENDAL B.Risk minimizing portfolios and HJBI equations for stochastic differential games[J].Stochastics an International Journal of Probability and Stochastic Processes,2008,80(4):317-337.